03 / AI REPO RADAR
xerj-org/xerj
12.458 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Công cụ tìm kiếm chạy cục bộ kiêm máy chủ MCP trong một file Rust: lập chỉ mục mã, tài liệu, log để agent truy vấn đúng đoạn cần thay vì đọc từng file.
XERJ là gì và giải quyết vấn đề nào
XERJ là một công cụ tìm kiếm chạy cục bộ kiêm máy chủ MCP dành cho AI agent. Theo README, toàn bộ nằm trong một file nhị phân viết bằng Rust, có thể lập chỉ mục mã nguồn, tài liệu, log, file JSONL, CSV và PDF, rồi cho phép tìm kiếm toàn văn kiểu BM25, tìm kiếm vector và tìm kiếm lai. Phía trước là một API tương thích Elasticsearch, nên các client và công cụ quen thuộc có thể trỏ vào mà không cần sửa. Repo thuộc tổ chức xerj-org, dùng giấy phép Apache-2.0 và tại thời điểm thu thập có 12.458 sao trên GitHub.
Vấn đề README nhắm tới khá cụ thể: coding agent thường đọc từng file một và tiêu tốn rất nhiều token chỉ để tìm đúng đoạn mã cần dùng. XERJ muốn thay việc đọc file bằng việc truy vấn một chỉ mục, để agent chỉ nhận về đoạn liên quan. README gọi trường hợp dùng chính là reference coding: giao cho agent một tác vụ, nó tải về các repo mã nguồn mở gần nhất với bài toán, lập chỉ mục chúng và tái sử dụng cách những dự án đó đã giải quyết trước khi tự viết mã của mình.
Ngoài lập trình tham chiếu, README liệt kê thêm các hướng dùng khác: hỏi đáp về codebase, audit bảo mật, phân tích log và sự cố, bộ nhớ dài hạn cho agent và thay thế Elasticsearch. Bài này đi qua từng phần theo đúng những gì README mô tả. Chỗ nào README không nói tới, bài sẽ ghi rõ là README không đề cập, thay vì đoán.
Vì sao grep chưa đủ cho agent
README đưa ra một lập luận về ngữ cảnh. Một agent chạy grep chỉ biết được chỗ cần nhìn, vì mỗi kết quả grep là một dòng, và để đánh giá dòng đó agent vẫn phải mở cả file. Theo số đo của tác giả, trên một corpus có trường hợp agent kéo vào tới 1.06M token đầu vào. Ngược lại, agent truy vấn XERJ chỉ nhận về đoạn văn bản cụ thể, và README nói mỗi câu hỏi chỉ tốn cỡ vài kilobyte.
Ví dụ README nêu là lõi WordPress: phần PHP khoảng 5.2 triệu token, tương đương 26 cửa sổ ngữ cảnh đầy đủ, nên agent không thể đơn giản đọc hết. Trong một lần audit bảo mật lõi WordPress bằng AI mà tác giả mô tả, agent làm việc trên 1.492 file PHP với khoảng 26.000 token, tức chỉ bằng lượng cần để nạp khoảng nửa phần trăm cây mã nguồn. Đây là số liệu tác giả tự công bố; README dẫn sang tài liệu riêng thay vì trình bày cách đo ngay trong trang chính.
Điểm đáng chú ý là README tự nêu điều kiện áp dụng. Giá trị lớn nhất nằm ở mã riêng tư, mã nội bộ, mã ngách hoặc mã mới hơn mốc kiến thức của mô hình. Với các thư viện công khai phổ biến mà mô hình đã thuộc, tác dụng là trung tính hoặc thậm chí có hại. Nói cách khác, XERJ không được giới thiệu như viên đạn bạc mà như công cụ bù đắp chỗ mô hình thiếu kiến thức.
Cách hoạt động: autoindex một thư mục
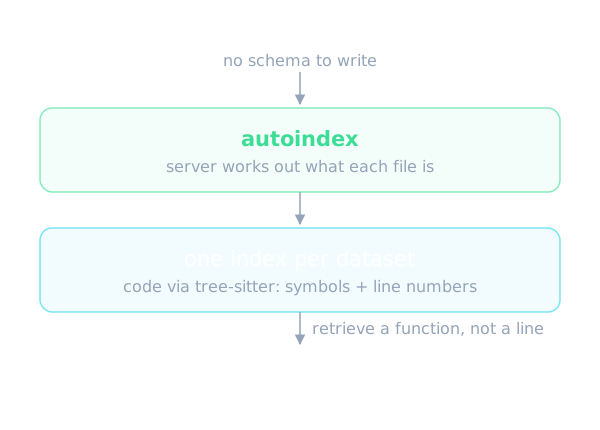
Lệnh trung tâm là autoindex. Bạn khởi động máy chủ rồi trỏ autoindex vào bất kỳ thư mục nào. README nói không cần viết schema hay cấu hình pipeline: XERJ tự nhận dạng từng file, xác định nó là loại gì và tạo một chỉ mục cho mỗi tập dữ liệu tìm thấy. Mã nguồn đi qua tree-sitter nên khi được lập chỉ mục, agent nhận về cả ký hiệu lẫn số dòng, thay vì văn bản phẳng. Nhờ vậy agent tìm được một hàm chứ không chỉ một dòng.
Danh sách định dạng README liệt kê khá dài: CSV, JSON, JSONL, XML, YAML, SQLite, PDF, DOCX, PowerPoint với mỗi slide là một bản ghi, Excel với mỗi sheet là một tập dữ liệu, sách EPUB theo từng chương, notebook Jupyter theo từng mục tiêu đề, trang man, HTML, thư điện tử gồm eml và mbox, cùng các định dạng log phổ biến. Dự án Unity còn được xử lý riêng: scene, prefab và asset dạng văn bản thành từng bản ghi cho mỗi GameObject hoặc Component, file meta thành bảng ánh xạ GUID sang đường dẫn.
Về lập chỉ mục mã, README cho biết việc lập lại chỉ mục là tăng dần: file có nội dung giống hệt lần trước thì bỏ qua bước phân tích cú pháp và dùng lại kết quả đã commit. Tác giả viết rằng thường hơn 95% file không đổi trong tình huống sửa rồi chạy lại hoặc CI. Tuy vậy mã băm toàn bộ nội dung vẫn phải chạy để phát hiện thay đổi, nên tổng thời gian bị chặn dưới bởi bước băm chứ không phải bước phân tích cú pháp.
Số liệu đo lường do tác giả công bố
Phần được README nhấn mạnh nhất là một nghiên cứu có kiểm soát về reference coding. Theo mô tả, thử nghiệm gồm 8 tác vụ trên 4 ngôn ngữ, mỗi nhánh chạy 16 lần, dùng số đếm token thật từ lệnh claude -p, trên mã mà mô hình chưa thuộc. Ba nhánh được so sánh: chỉ dùng trí nhớ của mô hình, agent dùng grep và agent dùng XERJ.
Kết quả trong bảng của README như sau. Chỉ dùng trí nhớ tốn 260.916 token đầu ra, chi phí 11.18 đô la và giải được 11 trên 16 tác vụ. Agent dùng grep tốn 26.477 token, 3.27 đô la và giải được 16 trên 16. XERJ tốn 9.982 token, 1.58 đô la và cũng giải được 16 trên 16. Từ đó tác giả tính ra ít hơn grep 2.7 lần token đầu ra và ít hơn dùng trí nhớ 26 lần với cùng tỷ lệ giải, rẻ hơn 2.1 lần, và tới 278 lần ít hơn trên một tác vụ Java.
README còn kể một lần chạy bổ sung: 9 trên 9 khi có truy xuất so với 0 trên 9 khi chỉ dùng trí nhớ, trên một thư viện Rust mà mô hình chưa từng thấy. Ngoài ra, README dẫn các báo cáo thực địa của người dùng, nói rằng trong công việc hằng ngày họ thấy khoảng 5 lần ít token hơn. Tất cả những con số này là tuyên bố của tác giả. README trỏ tới case study và các field report để người đọc tự kiểm tra, còn bài này không tự kiểm chứng lại chúng.
Kết nối agent qua MCP
Không phải agent nào cũng chạy được lệnh shell. Các trợ lý dạng desktop hoặc host gọi hàm truy cập công cụ qua Model Context Protocol, và README nói chính file nhị phân vừa cài đã là máy chủ MCP, không cần tải hay biên dịch thêm. Lệnh xerj mcp nói chuyện MCP qua stdio và chuyển tiếp tới node được chỉ định bởi biến XERJ_URL. Nó không tự khởi động node, nên bạn phải chạy node trước. Máy chủ MCP không thêm ranh giới tin cậy nào của riêng nó; ranh giới thực sự vẫn là của node.
Có mười bảy công cụ được mở ra. Mười một trong số đó là lớp ủy quyền mỏng trên endpoint có sẵn: tìm kiếm theo query DSL kiểu Elasticsearch, tìm kiếm ngữ nghĩa trên trường semantic_text, tìm kiếm kNN trên dense_vector, tìm kiếm lai bằng RRF hoặc kết hợp tuyến tính, lưu và gọi lại bộ nhớ agent trong một namespace, bốn công cụ cho chỉ mục liên kết kiểu second brain, và xerj_plan biến bộ lọc bằng lời thường thành query DSL đã được kiểm tra. README nhấn mạnh xerj_plan dựa trên luật xác định chứ không phải một LLM.
Hai công cụ không phải proxy thuần: xerj_map trả bản đồ trường theo chỉ mục từ catalog của autoindex, còn xerj_code_search chạy pipeline reference coding và trả văn bản đã dựng. Bốn công cụ còn lại gồm xerj_field_report để gửi báo cáo thực địa và ba công cụ hub để trả lời từ các gói Corpus Hub có sẵn trên máy.
README cũng nói schema công cụ được sinh từ một lần gọi tools/list thật chứ không viết tay, và được kiểm trong CI cùng một unit test để danh sách công bố không lệch với danh sách thực tế. Một lưu ý thực dụng: hãy dùng đường dẫn tuyệt đối trong cấu hình MCP, vì host khởi chạy từ biểu tượng desktop không thừa hưởng PATH của shell. Nếu node chạy có xác thực thì cần thêm biến XERJ_AUTH vào cấu hình.
Bộ nhớ agent, tìm kiếm lai và chấm điểm với Jev
Với bộ nhớ dài hạn, README mô tả đường dẫn memory theo namespace: agent lưu những gì nó học được khi làm việc và gọi lại theo ý nghĩa ở phiên sau. Một prompt mẫu trong README yêu cầu agent dùng API notes của memory làm trí nhớ dài hạn cho dự án. README cũng nhắc tới tri thức dạng đồ thị trên tài liệu của bạn. Chi tiết về độ bền dữ liệu hay giới hạn dung lượng của bộ nhớ thì README chính không đề cập.
Về tìm kiếm ngữ nghĩa, README cảnh báo rằng embedder mặc định là lexical feature-hashing chứ không phải neural, trừ khi node chạy với chế độ embed neural. Chế độ neural cần ba file mô hình được đặt sẵn cục bộ trước thao tác ngữ nghĩa đầu tiên. Điều này đáng biết trước khi kỳ vọng chất lượng ngữ nghĩa thật sự từ cấu hình mặc định.
README có một phần về Jev, dịch vụ của TypeSafe AI chấm điểm từ 0 đến 1 mức độ một tài liệu trả lời được câu hỏi. Có hai cách dùng. Cách thứ nhất, thêm rerank vào truy vấn để XERJ gửi các kết quả đầu cho Jev rồi sắp xếp lại. Trên bài kiểm tra FiQA công khai, chất lượng nDCG@10 đi từ 0.24 lên 0.36 với tổng chi phí khoảng 0.64 đô la cho 648 lượt tìm. README cảnh báo rõ rằng cách này gửi nội dung kết quả tới máy chủ của TypeSafe, mặc định tắt cho tới khi bạn đặt khóa, và có thể cấm hẳn bằng cấu hình.
Cách thứ hai, các endpoint tương thích nhận cùng loại câu hỏi nhưng XERJ tự trả lời cục bộ bằng cách tra những tài liệu tương tự đã có nhãn, ví dụ thư đã đánh dấu là spam hay không. Không dữ liệu nào rời máy và không cần khóa, nhưng cách này chỉ hoạt động nếu bạn đã có ví dụ gắn nhãn. Trên AG News với 120k ví dụ có nhãn, README nói nó chọn đúng nhãn 92% số lần. Câu trả lời mang tên riêng của XERJ chứ không phải Jev.
Cài đặt và dùng thử
README mô tả hai đường vào. Đường nhanh là cài bằng một prompt duy nhất, trong đó agent đọc tệp llms.txt để biết các bước theo thứ tự: cài đặt, khởi động máy chủ, chạy autoindex trên thư mục hiện tại, truy vấn bằng bất kỳ client Elasticsearch nào, rồi vòng lặp reference coding gồm tải repo tương tự, lập chỉ mục, truy xuất cơ chế trước khi viết, ghi nguồn đã dùng và tôn trọng giấy phép của chúng.
Đường thủ công là một file nhị phân tĩnh, không cần JVM và không có phụ thuộc, có bản dựng sẵn cho Linux, macOS và Windows trên x86-64 và arm64, hoặc có thể build từ mã nguồn với toolchain Rust ổn định. Lệnh đầu tiên sau khi cài là khởi động node với cờ insecure và một thư mục dữ liệu, chờ node phản hồi, rồi chạy autoindex trên thư mục dự án. README không đưa ra yêu cầu phần cứng cụ thể.
Hai chi tiết vận hành README nhấn mạnh. Thứ nhất, thư mục dữ liệu phải nằm ngoài thư mục bạn autoindex, vì thư mục data không nằm trong danh sách bỏ qua mặc định nên node sẽ tự lập chỉ mục chính kho lưu trữ của nó. Thứ hai, nếu máy chủ bật xác thực, vốn là mặc định cho mọi lần khởi động không có cờ insecure, thì autoindex phải nhận cùng khóa API qua cờ hoặc biến môi trường, nếu không mọi yêu cầu sẽ trả về 401. Với máy không có internet, README dẫn tới công thức triển khai air-gapped; embedder lexical mặc định chạy offline.
Tương thích Elasticsearch và benchmark
XERJ cài đặt REST API của Elasticsearch gồm index, document, bulk, search, aggregation, mapping, kNN, scroll, reindex và các endpoint cat. Kibana và các client chính thức kết nối trực tiếp được. README nói rõ đây là tương thích API, không phải cài lại phần lõi của Elasticsearch và không phải một bản fork. Bộ kiểm thử tương thích chạy ở mỗi commit và hiện qua 1366 trên 1369 ca, phần còn lại được liệt kê công khai.
Một ranh giới cần biết trước khi dùng công cụ xuất dữ liệu: scroll là ảnh chụp dựng sẵn có giới hạn, nên truy vấn có tổng vượt cửa sổ ảnh chụp sẽ bị từ chối với lỗi 400 thay vì bị cắt bớt âm thầm. Với tập kết quả lớn, README khuyên dùng search_after.
Về hiệu năng, tác giả so XERJ với Elasticsearch 8.13.4 qua nạp dữ liệu, tìm toàn văn, aggregation, tìm vector và các lần đọc khi có luồng ghi dồn dập. Lần chạy vòng kín gần nhất cho 55 thắng, 26 hòa, 4 thua, gồm thông lượng nạp gấp 1.72 lần và dung lượng đĩa nhỏ hơn 1.61 lần. Cả bốn trận thua cùng một lỗ hổng: độ trễ p99 khi đọc trong lúc có writer tốc độ cao, và tác giả nói họ đã viết riêng về nó. Đây đều là kết quả tự công bố; README mời chạy lại và khuyên hoài nghi mọi con số không tái lập được, kể cả của chính họ.
Với lập chỉ mục mã, trên một bản checkout Apache Lucene gồm 6.113 file mã nguồn, 51 MB, việc trích xuất đơn luồng trong tiến trình đạt khoảng 1.500 file mỗi giây, tức 13 MB mỗi giây, trong đó phân tích cú pháp tree-sitter chiếm khoảng 72%. Tác giả coi đó là mức sàn cho mỗi file.
Giới hạn và vấn đề an toàn
Điểm an toàn quan trọng nhất README tự nhấn mạnh: cờ insecure tắt TLS và xác thực, nghĩa là mọi bên gọi tới được cổng đều là superuser, có thể đọc và xóa mọi chỉ mục, kể cả mọi namespace bộ nhớ. Cấu hình này dành cho một người dùng trên máy phát triển. Node mới khởi động chỉ gắn vào 127.0.0.1, và việc bind không mã hóa trên giao diện khác sẽ bị từ chối khởi động nếu bạn không cho phép rõ ràng.
README còn thừa nhận vài giới hạn khác. Giá trị đo được phụ thuộc vào việc mô hình có thuộc mã đó hay không. Rerank với Jev là tính năng duy nhất khi tìm kiếm gửi văn bản tài liệu ra khỏi node, cần khóa nhà cung cấp do vận hành viên cấu hình, và chất lượng xếp hạng với mô hình thật chưa được kiểm chứng. Embedder mặc định không phải neural. Ngoài ra dự án có một cơ chế cộng đồng: README mong người dùng gửi một báo cáo thực địa ngắn qua một commit hoặc PR, chấp nhận cả con người lẫn agent.
Về giấy phép, README ghi Apache 2.0. README không đề cập yêu cầu bộ nhớ, giới hạn kích thước chỉ mục tối đa hay hướng dẫn nâng cấp giữa các phiên bản, nên nếu cần các thông tin đó bạn phải đọc tài liệu riêng của dự án.
Khi nào nên và không nên dùng
Theo những gì README mô tả, XERJ hợp khi agent của bạn phải làm việc trên một khối tri thức lớn mà đọc thẳng vào ngữ cảnh là không thực tế: mã nội bộ, repo ngách, mã mới hơn mốc kiến thức của mô hình, đống log hỗn hợp hay bộ tài liệu hàng loạt. Nó cũng hợp nếu bạn cần một công cụ cục bộ, một file nhị phân, nói được cả giao thức Elasticsearch lẫn MCP, thay vì dựng riêng cụm tìm kiếm và cơ sở dữ liệu vector.
Ngược lại, nếu agent chủ yếu làm việc với các thư viện công khai nổi tiếng mà mô hình đã thuộc, README thừa nhận lợi ích là trung tính hoặc có hại. Nếu bạn không muốn chạy một máy chủ cục bộ cùng quy tắc bảo mật phải tự quản lý, hoặc cần chất lượng ngữ nghĩa neural ngay từ cấu hình mặc định, hãy cân nhắc kỹ. Và vì các số liệu hiệu năng là do tác giả công bố, hãy thử trên chính dữ liệu của bạn trước khi dựa vào chúng.
Tóm lại, XERJ là một lựa chọn đáng thử cho người xây agent đang gặp nút thắt về ngữ cảnh, miễn là bạn đọc kỹ ranh giới tin cậy của chế độ insecure và coi các con số trong README như những tuyên bố cần tái lập.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.