03 / AI REPO RADAR
thedotmack/claude-mem
107.971 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Hệ thống bộ nhớ bền vững cho coding agent: ghi lại thao tác trong phiên, nén thành bản tóm tắt bằng AI rồi đưa ngữ cảnh liên quan vào các phiên sau, có công cụ MCP để tìm lại.
claude-mem là gì và giải quyết vấn đề nào
claude-mem là một hệ thống bộ nhớ bền vững mã nguồn mở dành cho coding agent. README mô tả nó là hệ thống nén bộ nhớ xây cho Claude Code: ghi lại những gì agent làm trong phiên, nén lại bằng AI, rồi đưa ngữ cảnh liên quan vào các phiên sau. Phần mô tả repo còn nêu thêm nhiều môi trường khác như OpenClaw, Codex, Gemini, Hermes, Copilot và OpenCode. Tại thời điểm lấy dữ liệu, repo có 107.971 sao và dùng giấy phép Apache-2.0.
Vấn đề mà công cụ này nhắm tới quen thuộc với bất kỳ ai làm việc lâu với agent: khi phiên kết thúc hoặc kết nối lại, agent quên sạch. Các quyết định thiết kế, bản sửa lỗi và lý do đằng sau chúng biến mất, người dùng phải giải thích lại từ đầu. Theo README, claude-mem giữ ngữ cảnh qua các phiên bằng cách ghi nhận các quan sát về việc dùng công cụ, tạo bản tóm tắt ngữ nghĩa và cung cấp chúng cho phiên tương lai, để Claude duy trì được tính liên tục về hiểu biết đối với dự án.
Bài viết này chỉ dựa trên README và metadata của repo. Chỗ nào README không nói, ví dụ định dạng lưu trữ chi tiết của bản tóm tắt hay chất lượng truy hồi đo được, bài sẽ nói rõ là README không đề cập chứ không đoán. README cũng có phần mang tính quảng bá, như gói dùng thử có host và một token cộng đồng; bài coi đó là bối cảnh chứ không phải khẳng định kỹ thuật.
Cách hoạt động: hook, worker và cơ sở dữ liệu
README liệt kê sáu thành phần chính. Thứ nhất là các lifecycle hook: SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop và SessionEnd. Mỗi hook là một lệnh không qua shell, chạy bởi một launcher nhỏ mà trình cài đặt đặt vào PATH. Nhờ bám vào vòng đời phiên, công cụ ghi nhận được thao tác của agent mà không cần người dùng làm thủ công.
Các thành phần còn lại gồm một bộ kiểm tra phụ thuộc có cache gọi là Smart Install, một worker service là API HTTP cục bộ kèm giao diện web và các endpoint tìm kiếm do Bun quản lý, cơ sở dữ liệu SQLite lưu phiên, quan sát và bản tóm tắt, skill mem-search để hỏi bằng ngôn ngữ tự nhiên, và cơ sở dữ liệu vector Chroma cho tìm kiếm lai giữa ngữ nghĩa và từ khóa. Tài liệu kiến trúc trong repo nhắc tới lược đồ SQLite với tìm kiếm FTS5 và kiến trúc tìm kiếm lai với Chroma.
Luồng dữ liệu tổng quát, theo cách README diễn đạt, là: hook thu quan sát, worker và cơ sở dữ liệu lưu lại, bước nén bằng AI tạo bản tóm tắt, và khi phiên mới bắt đầu thì ngữ cảnh liên quan được chèn trở lại. README không mô tả chi tiết thuật toán chọn ngữ cảnh nào được chèn; phần đó nằm trong tài liệu kiến trúc mà README chỉ dẫn tới, nên bài này không suy đoán thêm.
Bộ công cụ tìm kiếm ba lớp và mục tiêu tiết kiệm token
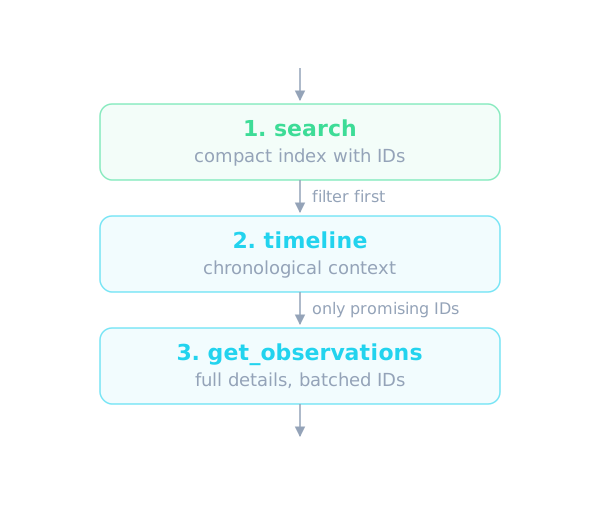
Phần đáng chú ý nhất về mặt thiết kế là cách truy hồi. claude-mem cung cấp tìm kiếm bộ nhớ qua công cụ MCP theo mô hình ba lớp tiết kiệm token. Bước một là search, trả về một chỉ mục gọn kèm ID, với chi phí khoảng 50-100 token mỗi kết quả. Bước hai là timeline, cho ngữ cảnh theo thứ tự thời gian quanh một quan sát hoặc truy vấn. Bước ba là get_observations, chỉ lấy chi tiết đầy đủ cho những ID đã được lọc, khoảng 500-1.000 token mỗi kết quả.
Ý tưởng là lọc trước khi tải. Agent dùng search để xem có gì liên quan, dùng timeline để hiểu bối cảnh xung quanh, và chỉ gọi get_observations cho vài ID thật sự cần, nên không phải nạp toàn bộ lịch sử vào cửa sổ ngữ cảnh. README nói cách làm này tiết kiệm khoảng 10x token. Đây là con số do tác giả tự công bố; README không kèm phương pháp đo nên bài không thể kiểm chứng.
README lưu ý nên gom nhiều ID vào một lần gọi get_observations. Phần mô tả công cụ nhắc đến ba công cụ chính là search với bộ lọc theo loại, ngày và dự án, timeline, và get_observations; trong khi tiêu đề nói có bốn công cụ MCP. README không nêu rõ công cụ thứ tư là gì, một điểm không nhất quán nhỏ mà người đọc nên biết trước khi tích hợp.
Cài đặt và dùng thử
README đưa ra nhiều đường cài đặt, mỗi đường cho một môi trường. Cách chung là một lệnh cài đặt qua npx, và cách thứ hai là cài từ plugin marketplace bên trong Claude Code. Ngoài ra có các hướng dẫn riêng cho OpenCode từ phiên bản 1.3.4 trở lên, cho T3 Code, cho Antigravity CLI, cho OMP, cho phần mở rộng Pi gốc và plugin DeepSeek Harness, cũng như cổng OpenClaw. Sau khi cài, README yêu cầu khởi động lại công cụ, và ngữ cảnh của các phiên trước sẽ tự xuất hiện trong phiên mới.
Có một lưu ý quan trọng trong README: claude-mem cũng được đăng trên npm, nhưng cài toàn cục bằng npm chỉ cài SDK hoặc thư viện, không đăng ký hook của plugin và không dựng worker service. Vì vậy nên cài bằng lệnh npx claude-mem install hoặc các lệnh plugin được nêu, thay vì cài gói npm thuần.
Về yêu cầu hệ thống, README liệt kê Node.js từ 20.0.0 trở lên, một phiên bản Claude Code mới có hỗ trợ plugin, Bun làm runtime và trình quản lý tiến trình sẽ tự cài nếu thiếu, uv cho tìm kiếm vector cũng tự cài nếu thiếu, và SQLite 3 đi kèm sẵn. Với Windows, README có ghi chú riêng: các hook không cần Git Bash, và trình cài đặt đặt launcher vào một thư mục người dùng rồi thêm vào Path, nên cần khởi động lại terminal hoặc IDE sau khi cài.
Tính năng chính theo README
README nêu một danh sách tính năng. Bộ nhớ bền vững giúp ngữ cảnh sống sót qua các phiên. Tiết lộ lũy tiến cho phép truy hồi theo lớp và cho biết chi phí token của từng lớp. Tìm kiếm thông minh mặc định dùng quy trình ba bước của skill mem-search để hỏi lịch sử dự án. Ngoài ra có skill cho Claude Desktop để tìm bộ nhớ từ các cuộc trò chuyện ở đó, và hệ thống trích dẫn cho phép tham chiếu các quan sát cũ bằng ID thông qua API của worker hoặc xem trong trình xem web.
README còn mô tả giao diện My Work cục bộ, hiển thị các yêu cầu đang chạy, tiến độ, các lần bàn giao cho con người và hàng đợi xem xét đã lưu, tại địa chỉ worker in ra khi khởi động; bộ nhớ, phiên và cài đặt nằm ở trang viewer. TeamBrain là một không gian chia sẻ tùy chọn cho nhóm, có danh sách việc, ghi nhận thành viên và các phát hiện liên kết; README nói mỗi người tự chọn chia sẻ gì, còn yêu cầu và ghi chú xem xét cá nhân vẫn tách riêng.
Các tính năng khác gồm kiểm soát ngữ cảnh chi tiết về việc cái gì được chèn vào, vận hành tự động không cần can thiệp thủ công, và tính năng ảnh chụp màn hình tùy chọn, mặc định tắt. Khi bật, bản sao ảnh được giữ trong thư mục dữ liệu của người dùng, chỉ tải lên dịch vụ đám mây khi bật đồng bộ đám mây, và chỉ gửi cho mô hình quan sát khi suy luận trên ảnh được bật riêng.
Dùng trong quy trình làm việc với AI agent
Với người xây agent, giá trị thực tế nằm ở việc biến nhật ký làm việc thành tài sản dùng lại. Một phiên sửa lỗi hôm nay để lại quan sát về nguyên nhân và cách sửa; phiên sau, khi gặp lỗi tương tự, agent có thể tìm lại thay vì khám phá từ đầu. Theo mô tả của README, ngữ cảnh liên quan được chèn tự động khi phiên bắt đầu, nên quy trình hằng ngày gần như không đổi.
Khi cần đào sâu, quy trình ba lớp phù hợp với cách agent làm việc có kiểm soát ngân sách ngữ cảnh: tìm chỉ mục gọn trước, xem dòng thời gian quanh các kết quả hứa hẹn, rồi chỉ tải chi tiết cho vài ID. Cách này giúp agent tránh việc nhồi toàn bộ lịch sử vào prompt, điều thường làm tăng chi phí và làm loãng sự chú ý của mô hình.
README cũng cho thấy công cụ không chỉ dành cho một agent. Nó hỗ trợ nhiều môi trường và có tùy chọn gộp quan sát từ mọi harness vào ngữ cảnh khởi đầu của Claude Code và Codex, bằng cách bật cài đặt gộp mọi nguồn khi bắt đầu phiên trong tệp cài đặt hoặc trong trình xem; mặc định là false, tức ngữ cảnh khởi đầu chỉ lấy từ harness hiện tại. Giới hạn số quan sát vẫn áp dụng trên các nguồn đã chọn. Với đội dùng nhiều agent khác nhau, đây là cách dùng một kho bộ nhớ chung.
Cấu hình, quyền riêng tư và chế độ ngôn ngữ
Cài đặt nằm trong một tệp settings.json ở thư mục dữ liệu của claude-mem trong thư mục người dùng, tự tạo với giá trị mặc định ở lần chạy đầu. Tệp này điều khiển mô hình AI, cổng của worker, thư mục dữ liệu, mức log và cài đặt chèn ngữ cảnh. Về quyền riêng tư, README nói có thể dùng thẻ để loại nội dung nhạy cảm khỏi bộ nhớ, nhưng không đi sâu vào cú pháp thẻ trong phần chính; chi tiết nằm ở tài liệu riêng.
Công cụ hỗ trợ nhiều chế độ làm việc và ngôn ngữ qua cài đặt CLAUDE_MEM_MODE. Cài đặt này điều khiển cả hành vi quy trình, ví dụ code, chill hay investigation, lẫn ngôn ngữ của các quan sát được tạo ra. Chế độ code là tiếng Anh mặc định, code--zh là tiếng Trung giản thể, code--ja là tiếng Nhật, và các chế độ ngôn ngữ khác theo mẫu code--mã ngôn ngữ ISO 639-1. Chế độ tiếng Trung giản thể đã có sẵn, không cần cài thêm. Sau khi đổi chế độ cần khởi động lại Claude Code.
Về lựa chọn nhà cung cấp mô hình cho bước nén, README nêu rằng sau khi đăng nhập có thể chọn observer của claude-mem, khóa OpenRouter hoặc Gemini của riêng mình, hoặc gói Anthropic của người dùng. Người không muốn đăng nhập có thể truyền cờ provider rõ ràng, đặt CLAUDE_MEM_ONLINE_OPTIN thành false, hoặc chạy trong môi trường CI không tương tác để trình cài đặt hoàn tất mà không cần tài khoản.
Giới hạn và điều cần lưu ý
Điều đầu tiên cần cân nhắc là bộ nhớ này dùng AI để nén, nghĩa là nội dung phiên của bạn được đưa qua một mô hình để tạo bản tóm tắt. Mặc định trong README là một dịch vụ bộ nhớ có host, với gói dùng thử 30 ngày sau khi đăng nhập bằng email; hết dùng thử thì bộ nhớ quay về dùng gói Anthropic của bạn trừ khi bạn đăng ký. Chế độ observer cục bộ là tùy chọn phải bật chủ động. Nếu dữ liệu dự án nhạy cảm, hãy đọc kỹ phần này trước khi đăng nhập.
Thứ hai, README tuyên bố khoảng 10x tiết kiệm token và mức sử dụng nhiều hơn tới 100% so với gói; đây đều là tuyên bố của tác giả, README không kèm benchmark hay cách đo. README cũng không nêu số liệu về độ chính xác truy hồi, độ trễ, hay dung lượng đĩa theo thời gian, nên bạn cần tự đo trong dự án của mình.
Thứ ba, README là một trang dài và có chỗ chưa gọn: phần Quick Start trộn nhiều hướng dẫn cài đặt cho nhiều môi trường, một số lệnh không hiện trong bản đọc, và có sự lệch nhỏ giữa số công cụ MCP nêu ở tiêu đề với danh sách công cụ. README cũng nhắc đến CMEM, một token do bên thứ ba tạo và được tác giả công nhận; đó là chuyện cộng đồng, không liên quan đến chức năng kỹ thuật của công cụ, và bạn không cần nó để dùng claude-mem.
Khi nào nên và không nên dùng
Nên thử claude-mem nếu bạn làm việc dài hạn với cùng một codebase qua nhiều phiên agent, hay phải giải thích lại các quyết định cũ, hoặc nếu bạn dùng nhiều harness và muốn một kho ký ức chung. Mô hình tìm kiếm ba lớp cũng phù hợp khi bạn quan tâm tới ngân sách token và muốn kiểm soát lượng ngữ cảnh được nạp.
Nên cân nhắc kỹ hoặc chưa dùng nếu dự án có dữ liệu nhạy cảm mà bạn không muốn đi qua mô hình bên ngoài, nếu bạn cần một công cụ nhỏ gọn không có worker và cơ sở dữ liệu chạy nền, hoặc nếu bạn cần bằng chứng định lượng về chất lượng truy hồi trước khi cam kết. Vì README không cung cấp benchmark độc lập, cách an toàn là thử trên một dự án nhỏ, bật công cụ xem web để quan sát những gì được lưu, rồi mới mở rộng.
Tóm lại, claude-mem là một giải pháp bộ nhớ có kiến trúc rõ ràng gồm hook, worker, SQLite và Chroma, cùng cách truy hồi ba lớp có chủ ý tiết kiệm token. Giấy phép Apache-2.0 cho phép nhúng vào công cụ của riêng bạn. Các tuyên bố hiệu năng cần được xem là của tác giả cho đến khi bạn tự kiểm chứng, và quyết định dùng chế độ host hay cục bộ nên dựa trên mức độ nhạy cảm của dữ liệu.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.