03 / AI REPO RADAR
HKUDS/DeepTutor
50.344 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Không gian học tập agent-native: chat, giải bài, tạo quiz, nghiên cứu và trực quan hóa dùng chung một runtime, kèm nhiều engine RAG và bộ nhớ nhiều tầng.
DeepTutor là gì và nhắm vào vấn đề nào
DeepTutor là dự án mã nguồn mở của nhóm HKUDS, được chính tác giả mô tả bằng một câu ngắn: gia sư cá nhân hóa suốt đời. README giới thiệu nó như một không gian học tập agent-native, nối các hoạt động gia sư, giải bài, tạo câu hỏi kiểm tra, nghiên cứu, trực quan hóa và luyện tập đến mức thành thạo vào cùng một hệ thống có thể mở rộng. Nói gọn lại, đây không phải một chatbot đơn lẻ mà là một workspace nơi nhiều hoạt động học tập dùng chung một lớp runtime bên dưới.
Theo metadata thu thập cho kỳ này, repo dùng giấy phép Apache-2.0, có 50344 sao và tăng thêm 8157 sao trong bảy ngày gần nhất. Những con số này chỉ cho thấy mức độ quan tâm của cộng đồng, không nói gì về chất lượng sư phạm của sản phẩm. Các topic gắn trên repo gồm ai-agents, multi-agent-systems, rag, deepresearch, cli-tool và interactive-learning, cho thấy dự án đứng ở giao điểm giữa agent, truy xuất tri thức và học tập tương tác.
Vì sao người xây AI agent nên quan tâm
Dù hướng đến người học, cách DeepTutor tổ chức hệ thống là một ví dụ về ứng dụng xây quanh năng lực của agent thay vì quanh một prompt duy nhất. README không tự định vị là framework agent đa dụng, nên cách đọc đúng hơn là xem nó như một thiết kế tham khảo: nó cho thấy một sản phẩm thực tế đã giải quyết thế nào các bài toán quen thuộc như quản lý phiên, truy xuất tri thức, bộ nhớ, công cụ và phân quyền.
Phần lớn README là lịch sử phát hành rất dài. Bản mới nhất được thông báo là v1.7.0 với các mục như cài đặt theo module, workspace học tập được làm mới, notebook dạng block với Dito, bài học video có giọng đọc, checkpoint embedding có thể tiếp tục và tutoring đáng tin cậy hơn. Danh sách dài các bản trước đó cho thấy nhịp phát triển nhanh của dự án. README cũng ghi rõ họ hoan nghênh mọi hình thức đóng góp và có trang roadmap để mọi người bình chọn hoặc đề xuất hạng mục mới.
Bài viết này chỉ dựa trên đúng nội dung README đã thu thập, và phần README đó bị cắt ở đoạn hướng dẫn cài đặt. Vì vậy những gì README không nói, ví dụ chi tiết kiến trúc bên trong hay chất lượng tutoring, sẽ được ghi rõ là không đề cập thay vì suy đoán.
Một runtime dùng chung cho mọi chế độ
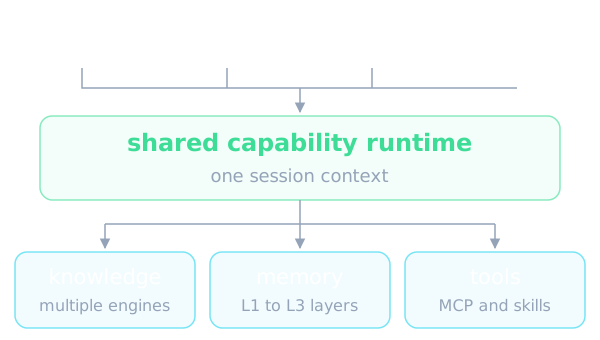
Mục tính năng chính nêu rằng Chat, Ask Questions, Quiz, Research, Visualize, Solve, Mastery Path, Immersive Reading và Audio Overview dùng chung một capability runtime và ngữ cảnh phiên, đồng thời vẫn giữ các vòng lặp và pipeline chuyên biệt cho từng chế độ. Điểm đáng chú ý là chia sẻ phần nền nhưng không ép mọi chế độ vào cùng một khuôn. Với người xây agent, đây là câu trả lời cho câu hỏi quen thuộc: làm sao cung cấp nhiều hành vi agent mà không phải lặp lại logic quản lý phiên ở mỗi nơi.
Lịch sử phát hành cho vài manh mối về cách runtime này tiến hóa. Bản v1.4.0 được mô tả là bản GA với Auto Mode, bộ nhớ ba tầng, các chế độ Deep Research, Solve và Question theo kiểu agentic, tái cấu trúc RAG sang LlamaIndex và runtime xử lý lượt hội thoại an toàn khi khởi động lại. Trước đó, v1.4.3 chuyển Chat sang một vòng lặp agent duy nhất, còn v1.0.0-beta.1 công bố bản viết lại theo kiến trúc agent-native với mô hình plugin Tools cộng Capabilities, kèm CLI và SDK. README không đi sâu hơn vào cách vòng lặp hoạt động, nên chi tiết nội bộ không được tài liệu ở đây.
Ngoài các chế độ chính, README nhắc đến Task Board để theo dõi việc học theo ba cột To do, In progress và Done, có ghi chú, kéo thả hoặc nút di chuyển dùng được bằng bàn phím, và kho lưu trữ có thể khôi phục. Thẻ ở lại trong workspace hiện tại và không cần cấu hình mô hình nào. Tính năng học bằng video cho phép thêm liên kết YouTube hoặc Bilibili vào Reading để phát trực tiếp, tìm trong bản ghi lời thoại, hỏi đáp bám theo mốc thời gian, lưu ghi chú và tiếp tục tiến độ; phụ đề và duyệt YouTube có thể dùng một máy chủ Invidious do quản trị viên cấu hình.
Tri thức nhiều engine: không buộc vào một backend truy xuất
README liệt kê phần tri thức đa engine gồm các thư viện RAG có phiên bản chạy trên LlamaIndex, PageIndex, GraphRAG, LightRAG, một LightRAG Server từ xa, kho tri thức WeKnora tự host, thư viện Tencent IMA hoặc MarginNote 4, kho lưu trữ Kiwix ZIM đã kết nối, hoặc một vault Obsidian được liên kết, cùng cơ chế phân tích tài liệu có thể thay thế. Ý nghĩa với người xây agent là lớp truy xuất không bị buộc vào một backend duy nhất, và nguồn tri thức có thể là ghi chú cá nhân lẫn kho tài liệu chuyên dụng.
Các ghi chú phát hành bổ sung thêm chi tiết, và đây là lời mô tả của chính tác giả. Bản v1.5.2 nói PageIndex có thể suy luận xuyên nhiều tài liệu bằng các lời gọi công cụ kiểu agentic. Bản v1.5.15 thêm PageIndex OSS tự host với truy xuất có suy luận và bộ phân tích Apache Tika. Bản v1.4.12 giới thiệu engine LightRAG Server, bộ phân tích PyMuPDF4LLM nhẹ và backend vector FAISS mà tác giả cho là giúp truy xuất kho tri thức lớn nhanh hơn đáng kể. Bản v1.6.10 có mô hình theo vai trò riêng cho LightRAG và một chỉ mục đã xuất bản ghi lại và buộc tuân theo những gì đã dựng nên nó.
Những chi tiết vận hành cũng đáng đọc. Bản v1.3.0 có chỉ mục tri thức theo phiên bản cùng quy trình lập chỉ mục lại; bản v1.5.1 cho phép gỡ riêng một tài liệu lỗi thay vì xóa và dựng lại cả kho; bản v1.7.0 có checkpoint embedding có thể tiếp tục; bản v1.0.3 có phát hiện embedding không khớp. Gộp lại, danh sách này phản ánh những cơn đau quen thuộc của RAG ngoài đời thực: lập chỉ mục lại, embedding lệch mô hình, tài liệu lỗi giữa chừng. README không đưa số liệu đối chiếu độc lập nào cho các engine.
Bộ nhớ nhiều tầng và ngữ cảnh học tập liên thông
README mô tả bộ nhớ có thể kiểm tra được: L1 là các dấu vết, L2 là tóm tắt theo bề mặt sử dụng, L3 là tổng hợp, nhằm làm cho việc cá nhân hóa hiển thị và chỉnh sửa được. Memory Graph nối các dữ kiện L2 với bằng chứng L1 và nối phần tổng hợp L3 với những bề mặt đã đóng góp vào nó. Thiết kế này đáng chú ý vì mỗi lớp tóm tắt đều trỏ ngược về bằng chứng gốc, nên người dùng có cơ sở để kiểm tra và sửa.
Phần ngữ cảnh học tập liên thông cho biết knowledge base, sách, trang Learning notebook, mục Favorites, ngân hàng câu hỏi, persona và Memory có thể được dùng lại giữa các quy trình hỗ trợ chúng, tùy theo quyền được cấp cho tài khoản và chính sách học tập. Ở phần lịch sử phát hành, v1.6.15 nhắc đến bộ nhớ tutoring có giới hạn, còn v1.4.8 nói mỗi Partner có bộ nhớ riêng tư của nó.
README không mô tả định dạng lưu trữ của bộ nhớ, cách tổng hợp L3 được tính, hay cách đo độ chính xác của việc cá nhân hóa. Vì vậy không có cơ sở trong nguồn để đánh giá chất lượng của lớp bộ nhớ này; chỉ có thể nói rằng ý tưởng ba tầng có liên kết bằng chứng là một mẫu thiết kế đáng tham khảo.
Subagent, Partner, công cụ và kỹ năng
Mục Subagents and Partners cho biết từ Chat có thể hỏi ý kiến một agent harness đang chạy, gồm Claude Code, Codex, Grok CLI, Antigravity, Kimi, opencode, MiMo, Hermes, OpenClaw hoặc DeepSeek, hoặc một Partner; có thể nhập lại các cuộc hội thoại cũ và chạy các người bạn đồng hành bền vững trên kênh nhắn tin cùng một bộ não. Bản v1.4.7 nói rõ hơn: kết nối Claude Code hoặc Codex chạy cục bộ và tham vấn nó trực tiếp ngay giữa một lượt trả lời.
Về Partner, bản v1.4.3 ghi rằng TutorBot trở thành Partners trên một pipeline nhắn tin cấp production với 15 kênh và phát trực tiếp. Bản v1.4.8 cho phép kết nối Partner riêng dưới My Agents và hỏi họ trong chat, họ trả lời bằng persona, thư viện và kỹ năng của chính mình. Bản v1.6.3 thêm tài khoản người học và người giám hộ.
Về công cụ, README liệt kê công cụ dựng sẵn, MCP server, CLI app, mô hình sinh ảnh, video và giọng nói, cùng các kỹ năng cộng đồng cài được từ EduHub. Bản v1.5.7 thêm kho MCP Services theo từng tài khoản và 101 CLI Apps mà gia sư có thể chạy, đồng thời đưa thông tin xác thực ra khỏi tầm với của sandbox. Bản v1.4.10 đặt công cụ MCP ở chế độ từ chối mặc định với người dùng không phải quản trị viên, còn v1.4.4 cho cài kỹ năng cộng đồng từ ClawHub qua một cổng kiểm tra bảo mật. Với người xây agent, đây là nhóm tính năng đáng học nhất: phạm vi công cụ theo tài khoản, từ chối mặc định và cách ly thông tin xác thực.
Cài đặt và dùng thử
README đưa ra một điểm khởi đầu khác thường: sao chép một prompt vào agent có quyền dùng terminal như Codex hoặc Claude Code và để agent tự cài DeepTutor. Cẩm nang cho lập trình viên và agent là cửa vào tài liệu cho cài đặt, kiến trúc, phát triển mở rộng, kiểm thử và xử lý sự cố, trong đó hướng dẫn Agent Setup bao quát toàn bộ quy trình cài, kể cả cấu hình CLI không tương tác.
Nếu tự cài, README nói có bốn đường cài đặt, tất cả dùng chung một cấu trúc thư mục runtime. Cài đặt riêng tư nằm dưới thư mục data/user/settings tính từ nơi khởi chạy, hoặc dưới đường dẫn đặt bằng biến DEEPTUTOR_HOME hoặc tùy chọn start home. Luồng khuyến nghị cho bản đầy đủ là chọn thư mục runtime, cài đặt, chạy lệnh khởi tạo, rồi khởi động. Thông báo của bản v1.7.0 nêu rằng cài bản đầy đủ qua pip với extra full sẽ có cả ứng dụng Web lẫn CLI, còn cài gói trần chỉ có phần lõi.
Các ghi chú phát hành còn nhắc đến hỗ trợ Python 3.14, triển khai Compose giữ toàn bộ thư mục data, khởi động sạch dưới Podman không cần quyền root, và lệnh chẩn đoán deeptutor doctor trong bản v1.5.17. Phần README thu thập được bị cắt ngay sau luồng khuyến nghị, nên chi tiết ba đường cài còn lại, yêu cầu phần cứng và chi phí gọi API mô hình không được đề cập trong nguồn.
Dùng trong workflow AI agent như thế nào
Như một thiết kế tham khảo, những ý tưởng dễ mang sang dự án khác nhất là: một runtime dùng chung cho nhiều chế độ, nhiều engine truy xuất sau cùng một giao diện, bộ nhớ nhiều tầng có liên kết bằng chứng, việc tham vấn các coding agent bên ngoài từ trong cuộc hội thoại, và quyền công cụ từ chối mặc định. Mỗi ý có thể đọc lại qua các ghi chú phát hành để thấy vì sao nó xuất hiện.
Như một sản phẩm, nhóm xây công cụ gia sư, onboarding hay đào tạo nội bộ có thể đánh giá trực tiếp DeepTutor với các thành phần như Books, Courses và Question Bank. Với triển khai nhiều người dùng, bản v1.3.8 nói về triển khai tùy chọn có workspace tách biệt cho từng người dùng, quyền cấp bởi quản trị viên và route xác thực; bản v1.4.1 nhắc đến cách ly tài nguyên theo người dùng.
Về tích hợp, README nhắc đến CLI và SDK từ bản viết lại ban đầu, cùng API HTTP/SSE cho TutorBot ở v1.4.1. README không cung cấp tài liệu API, nên người muốn nhúng DeepTutor vào hệ thống khác cần đọc cẩm nang của dự án.
Giới hạn và khi nào nên hoặc không nên dùng
Dự án thay đổi rất nhanh. Lịch sử phát hành có một bản tái cấu trúc front-end và back-end mang tính phá vỡ ở v1.6.3, cùng các bản sửa lỗi như v1.6.6 và v1.6.7 liệt kê những lỗi âm thầm đã được vá, chẳng hạn quiz không sinh ra gì hoặc nút sao chép nói dối. Điều đó cho thấy tác giả sửa lỗi tích cực, nhưng cũng cho thấy người dùng nên chuẩn bị cho nhiều thay đổi giữa các phiên bản. Mọi mô tả trong ghi chú phát hành là lời của tác giả, README không kèm benchmark độc lập.
Phạm vi cũng là một giới hạn: đây là cả một workspace học tập với giao diện, nhiều engine và nhiều tích hợp, nên nặng hơn nhiều so với một thư viện agent tối giản. README không đề cập chi phí gọi mô hình, yêu cầu phần cứng, cách đánh giá chất lượng tutoring hay chính sách dữ liệu khi gửi nội dung đến nhà cung cấp mô hình bên ngoài; những điểm này cần tự kiểm tra trước khi dùng với dữ liệu nhạy cảm.
Nên dùng nếu bạn cần nền tảng học tập tương tác để thử nghiệm hoặc muốn đọc một hệ thống agent đã trải qua nhiều vòng phát hành để học cách nó xử lý truy xuất, bộ nhớ và công cụ. Không nên chọn nếu bạn chỉ cần vài thành phần agent nhẹ, hoặc nếu bạn cần cam kết ổn định API trong thời gian dài mà README chưa đưa ra.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.