03 / AI REPO RADAR
headroomlabs-ai/headroom
77.575 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Lớp nén ngữ cảnh chạy cục bộ: giảm kích thước kết quả tool, log, đoạn RAG và file trước khi gửi cho LLM, dùng được như thư viện, proxy hoặc MCP server.
Headroom là gì
Headroom là một công cụ mã nguồn mở dùng để nén mọi thứ mà AI agent đọc vào, gồm kết quả của tool, log, các đoạn RAG, file và lịch sử hội thoại, trước khi chúng đến mô hình ngôn ngữ. Theo README, mục tiêu là giữ nguyên câu trả lời của mô hình nhưng chỉ tốn một phần nhỏ số token. Dự án dùng giấy phép Apache-2.0 và tại thời điểm thu thập có 77575 sao trên GitHub. Chủ đề gắn trên repo gồm context-engineering, token-optimization, mcp, proxy và rag, nên có thể xem đây là một lớp hạ tầng nằm giữa agent và nhà cung cấp mô hình.
README nhấn mạnh rằng việc nén diễn ra ngay trên máy của người dùng và không có prompt hay nội dung file nào bị gửi đi nơi khác để nén. Ví dụ mở đầu trong README là một đầu vào 10,144 token được nén còn 1,260 token mà agent vẫn tìm ra cùng một lỗi FATAL. Đây là ví dụ minh họa do tác giả đưa ra, không phải kết quả đo độc lập.
Vấn đề mà repo muốn giải quyết
Một coding agent đọc rất nhiều thứ trong một phiên làm việc: kết quả tìm kiếm trong mã nguồn, log của hệ thống, JSON trả về từ các MCP server, nội dung file và cả lịch sử hội thoại dài. Mỗi phần đó đều đi vào cửa sổ ngữ cảnh của mô hình và được tính tiền theo token. README không đi sâu vào chi phí tuyệt đối, nhưng cách trình bày cho thấy ý tưởng chính: phần lớn dữ liệu agent đọc có tính lặp lại cao, nên có thể rút gọn mà vẫn giữ lại những dòng quan trọng như lỗi hay giá trị bất thường.
Phần mô tả ngắn của repo nêu các con số mà tác giả tự công bố: 20% ít token hơn cho coding agent và từ 60-95% ít token hơn cho JSON, với cùng câu trả lời. README cũng tự giới hạn kỳ vọng: mức tiết kiệm phụ thuộc vào độ lặp lại của dữ liệu, còn văn xuôi hoặc đầu ra vốn đã cô đọng thì gần như không giảm được.
Cách hoạt động bên trong
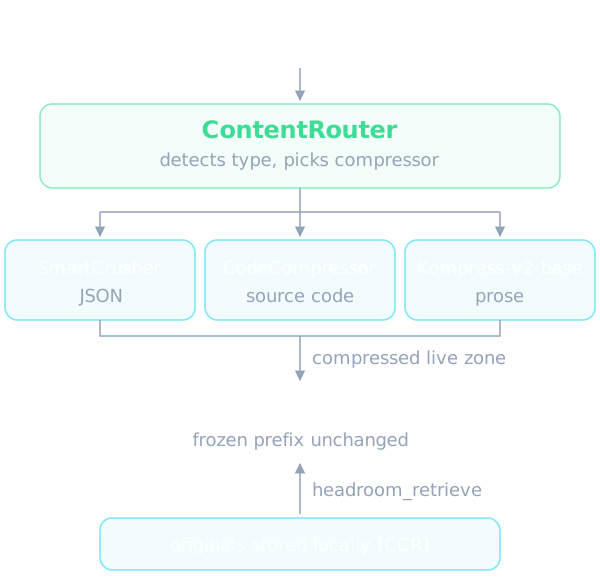
Theo README, luồng xử lý gồm một số thành phần. ContentRouter nhận biết loại nội dung rồi chọn bộ nén phù hợp. SmartCrusher xử lý JSON, CodeCompressor xử lý mã nguồn và Kompress-v2-base, một mô hình do nhóm tác giả huấn luyện trên các dấu vết của agent, xử lý văn xuôi. README mô tả SmartCrusher giữ lại các phần tử lỗi, các giá trị nằm ngoài khoảng thống kê bình thường và phần tử đầu cuối, được chọn dựa trên thống kê phương sai của từng trường chứ không dựa trên danh sách từ khóa. CodeCompressor hiểu cây cú pháp của Python, JS/TS, Go, Rust, Java, C/C++, C# và PHP.
Hai ý tưởng đáng chú ý khác là CacheAligner và CCR. CacheAligner đánh dấu nội dung hay thay đổi có thể làm hỏng tiền tố KV-cache của nhà cung cấp, nhưng README khẳng định nó không viết lại prompt. CCR là cơ chế nén có thể đảo ngược: bản gốc được lưu cục bộ và mô hình có thể gọi công cụ headroom_retrieve để lấy lại toàn văn khi cần. Ngoài ra Headroom chỉ nén vùng nội dung mới, tức output tool vừa xuất hiện và lượt gần nhất, còn phần tiền tố cũ giữ nguyên từng byte để cache của nhà cung cấp còn hiệu lực và lịch sử không bị bỏ đi.
Bốn cách tích hợp
README liệt kê nhiều cách đưa Headroom vào hệ thống. Cách thứ nhất là thư viện: hàm compress nhận danh sách message, có bản Python và bản TypeScript. Cách thứ hai là proxy chạy cục bộ trên cổng 8787, không cần đổi code và dùng được với mọi ngôn ngữ. Cách thứ ba là lệnh wrap, bọc sẵn nhiều agent như Claude Code, Codex, Grok, Copilot, Cursor, Aider, OpenCode, Cline, Continue, Goose và OpenHands trong một lệnh, có lệnh unwrap để hoàn tác. Cách thứ tư là MCP server với ba công cụ headroom_compress, headroom_retrieve và headroom_stats cho mọi MCP client.
Bảng tích hợp trong README còn nêu các điểm gắn cho Anthropic và OpenAI SDK, Vercel AI SDK, LiteLLM, LangChain, Agno, Strands và middleware ASGI. Với hệ thống nhiều agent có SharedContext để truyền ngữ cảnh đã nén giữa các agent. README không mô tả sâu từng tích hợp trong phần chính mà trỏ sang các trang hướng dẫn riêng, nên người dùng cần đọc thêm tài liệu đó trước khi áp dụng.
Số liệu do tác giả tự công bố
Phần Proof của README dựng bốn kịch bản từ định dạng output thật của các MCP server, đo bằng tokenizer của nhà cung cấp và hàm compress đã phát hành. Theo tác giả, tìm kiếm mã với 100 kết quả giảm từ 17,199 xuống 13,597 token, tức tiết kiệm 21%. Gỡ lỗi sự cố SRE giảm từ 55,957 xuống 24,340, tiết kiệm 57%. Khám phá codebase giảm từ 58,801 xuống 33,895, tiết kiệm 42%. Phân loại issue GitHub giảm từ 46,067 xuống 32,429, tiết kiệm 30%. Tác giả cho biết các phép đo chạy ngoại tuyến với dữ liệu cố định nên người khác có thể lặp lại.
Về độ trễ, tác giả công bố nén tốn dưới một mili giây: 0.21 ms ở phân vị 50 cho một kết quả tìm kiếm JSON cỡ 10K token và 1.4 ms ở 100K token. Về độ chính xác, bộ đánh giá cấp một cho GSM8K ra 0.870 ở cả hai bên, TruthfulQA đi từ 0.530 lên 0.560, SQuAD v2 đạt 97% với mức nén 19% và BFCL đạt 97% với mức nén 32%, mỗi bài dùng N=100. README tự lưu ý rằng ở N=100 chênh lệch cộng trừ 0.03 nằm trong khoảng tin cậy, nên TruthfulQA là chưa phát hiện khác biệt chứ không phải cải thiện. Tất cả đều là số liệu của tác giả, người dùng nên chạy lệnh đo tiết kiệm trên lưu lượng thật của mình.
Giảm token đầu ra
README lập luận rằng ngoài token gửi đi, người dùng còn trả tiền cho token mô hình viết ra, và với các mô hình cỡ Opus chi phí đầu ra gấp 5× đầu vào. Phần lớn đầu ra là nghi thức như lời mở đầu, in lại đoạn code vừa đọc hoặc suy luận sâu cho những bước thường như đọc file. Headroom xử lý điều này ngay ở proxy bằng hai cơ chế mà không cần đổi code.
Cơ chế đầu tiên là verbosity steering: thêm một ghi chú ngắn yêu cầu trả lời gọn ở cuối system prompt, để cache của prompt vẫn trúng. Cơ chế thứ hai là effort routing: hạ mức suy nghĩ khi lượt hiện tại chỉ là mô hình tiếp tục sau kết quả tool, ví dụ sau khi đọc file hoặc test đã qua, còn câu hỏi mới và lỗi vẫn giữ mức đầy đủ. Cả hai áp dụng cho API messages của Anthropic và các endpoint tương thích OpenAI. Vì không thể biết mô hình sẽ viết gì nếu không can thiệp, README nói rõ mức tiết kiệm đầu ra chỉ là ước tính kèm khoảng tin cậy, và cho phép giữ lại một phần hội thoại làm nhóm đối chứng để có số đo thật.
Bộ nhớ chung và học từ phiên thất bại
Ngoài nén, README nhắc đến bộ nhớ dùng chung giữa các agent: một kho duy nhất cho Claude, Codex, Gemini và Grok, có ghi nguồn gốc agent và tự loại trùng. Ở chế độ cache mặc định của proxy, việc tự chèn ngữ cảnh bộ nhớ vào đường Anthropic bị bỏ qua để tiền tố ổn định, và muốn tự chèn thì dùng chế độ token.
Lệnh headroom learn đọc các phiên thất bại và ghi sửa lỗi vào các file như CLAUDE.local.md, CLAUDE.md, AGENTS.md, GEMINI.md hoặc GROK.md. Mặc định là CLAUDE.local.md vốn được gitignore. Biến thể có tham số verbosity suy ra mức ngắn gọn mong muốn từ hành vi như ngắt câu trả lời dài. Bản README nguồn bị cắt ngay ở phần headroom learn nên chi tiết đầy đủ của lệnh này README nguồn không đề cập; cần xem tài liệu của dự án.
Cài đặt và mức tương thích
Headroom yêu cầu Python 3.10+ và có nhiều nhóm phụ thuộc tùy chọn như proxy, mcp, ml, code, memory, vector, relevance, image, agno, langchain và evals. README lưu ý lệnh headroom chỉ có trong gói PyPI, còn gói npm headroom-ai là SDK TypeScript để import, không cung cấp lệnh. Wheel dựng sẵn hiện phủ macOS Apple Silicon và Linux; trên macOS Intel README khuyên dùng bản Docker. Máy x86 không có AVX2 sẽ quay về đường xử lý không dùng ONNX, như BM25 và phát hiện theo heuristic, thay vì bị lỗi.
Bảng tương thích liệt kê nhiều agent hỗ trợ lệnh wrap. Cursor và ZCode cần cấu hình thủ công theo địa chỉ cơ sở mà proxy in ra, còn Cortex Code chỉ dùng được ở chế độ thư viện với mức tiết kiệm 60–65% theo tác giả. README cũng có hướng dẫn riêng cho mạng doanh nghiệp có kiểm tra SSL, GitHub Copilot trong VS Code và Claude Code trong VS Code, kèm lưu ý rằng một số luồng như Linux Secret Service chưa được kiểm chứng trên máy thật.
Giới hạn và khi nào nên dùng
README tự nêu khi nào nên dùng: chạy coding agent hằng ngày và muốn tiết kiệm mà không đụng vào code, làm việc với nhiều agent và muốn một bộ nhớ chung, hoặc cần nén có thể đảo ngược nhờ CCR. Khi nào nên bỏ qua: chỉ dùng cơ chế compaction sẵn có của một nhà cung cấp và không cần bộ nhớ chéo agent, hoặc làm việc trong sandbox không cho chạy tiến trình cục bộ. Hội thoại ngắn, văn xuôi và dữ liệu vốn đã cô đọng gần như không giảm, các khối dưới ngưỡng số từ tối thiểu được trả về nguyên vẹn.
Cần thận trọng với các mức tiết kiệm vì chúng là phép đo của chính tác giả trên bốn kịch bản định sẵn. Vì Headroom đứng giữa agent và nhà cung cấp mô hình, và bao gồm cả việc đổi cấu hình agent khi wrap, người dùng nên thử trước trên một dự án nhỏ, kiểm tra bằng lệnh đo tiết kiệm trên lưu lượng thật và nắm cách hoàn tác bằng unwrap trước khi áp dụng rộng.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.