03 / AI REPO RADAR
Graphify-Labs/graphify
129.243 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Skill cho trợ lý lập trình AI: dựng cả codebase cùng tài liệu, PDF, cấu hình thành đồ thị tri thức cục bộ để agent truy vấn thay vì grep từng file.
Graphify là gì và giải quyết vấn đề nào
Graphify là một dự án mã nguồn mở của nhóm Graphify-Labs, được mô tả là công cụ biến bất kỳ codebase nào, cùng tài liệu, schema SQL, file cấu hình và PDF, thành một đồ thị tri thức có thể truy vấn. Theo README, nó được phát hành dưới dạng một skill có tên graphify cho Claude Code, Cursor, Codex và Gemini CLI. Tại thời điểm thu thập dữ liệu, repo có 129.243 sao trên GitHub và dùng giấy phép Apache-2.0.
Vấn đề mà dự án nhắm tới rất quen thuộc với người dùng trợ lý lập trình AI. Khi hỏi về một codebase lớn, agent thường phải grep và mở hết file này đến file khác để tự dựng lại bức tranh tổng thể, và bức tranh đó biến mất sau mỗi phiên làm việc. Graphify đề xuất làm việc đó một lần: gõ lệnh graphify trong trợ lý AI, công cụ quét toàn bộ dự án gồm mã nguồn, tài liệu, PDF, ảnh và video, rồi lưu thành một đồ thị mà agent có thể hỏi lại bất kỳ lúc nào.
README nhấn mạnh ba ý. Thứ nhất, phần mã nguồn được lập bản đồ miễn phí và hoàn toàn cục bộ, vì mã được phân tích bằng cây cú pháp tree-sitter một cách xác định, không dùng mô hình ngôn ngữ và không có gì rời khỏi máy. Thứ hai, mọi cạnh trong đồ thị đều được giải thích. Thứ ba, đây không phải chỉ mục vector: không có embedding, không có kho vector, mà là một đồ thị thật để duyệt qua.
Cách hoạt động: đồ thị thay cho chỉ mục vector
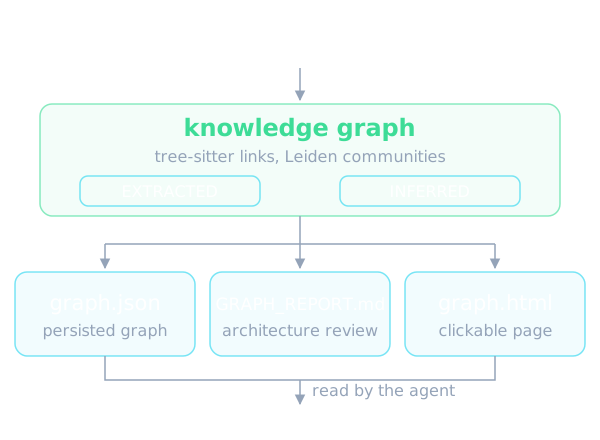
Theo README, mỗi kết nối trong đồ thị được gắn một trong hai nhãn. Nhãn EXTRACTED nghĩa là quan hệ đó nằm rõ ràng trong nguồn, còn nhãn INFERRED nghĩa là quan hệ do Graphify tự phân giải ra. Nhờ vậy người đọc, và cả agent, phân biệt được điều được đọc thẳng từ mã với điều chỉ là suy luận, đây là điểm khác biệt đáng chú ý so với các hệ thống truy hồi chỉ trả về đoạn văn bản gần giống.
Các liên kết giữa file như gọi hàm, import, kế thừa và mixes_in được phân giải xuyên file cho khoảng 40 ngôn ngữ lập trình thông qua phân tích cú pháp tree-sitter. Những chú thích trong mã có dạng NOTE hoặc WHY, cùng các trích dẫn ADR và RFC, được đưa vào đồ thị thành các nút riêng và nối với đoạn mã liên quan, nên lý do thiết kế cũng nằm trong cùng một bản đồ với mã.
Đồ thị được chia thành các cộng đồng, tức các hệ thống con, bằng thuật toán Leiden, và nhãn của chúng được đặt mà không cần mô hình ngôn ngữ. README cũng nhắc tới khái niệm god node, là các khái niệm có nhiều kết nối nhất, giúp thấy mọi thứ đang chảy qua đâu. Kết quả được ghi thành ba file, trong đó có graph.json là đồ thị lưu trữ, một bản báo cáo GRAPH_REPORT.md để xem kiến trúc tổng quát, và một trang graph.html có thể bấm để khám phá.
Đồ thị lưu trữ còn mang một trường schema_version để các tích hợp bên ngoài phát hiện được thay đổi định dạng không tương thích, cùng một trường graphify_version cho biết phiên bản Graphify đã tạo ra nó. README không mô tả chi tiết thêm về cấu trúc nội bộ của file này ở phần giới thiệu, mà dẫn người đọc sang tài liệu How graphify works.
Các tính năng chính
Phần Query, path, explain là cách dùng chính. Lệnh graphify query nhận một câu hỏi bằng ngôn ngữ thường và trả về một đồ thị con có phạm vi hẹp, lệnh graphify path truy ra cách hai thứ bất kỳ liên hệ với nhau, còn graphify explain giải thích một khái niệm. Tất cả chạy trên graph.json. README cho biết nếu một tên khớp với nhiều nút thì lệnh sẽ từ chối và liệt kê các ứng viên thay vì đoán, và script có thể đọc kết quả qua mã thoát: 0 là có câu trả lời, 3 là tên mơ hồ, 4 là không có nút khớp.
Ngoài mã nguồn, Graphify xử lý tài liệu, PDF, ảnh và video hoặc âm thanh, tất cả được đưa vào cùng một đồ thị. README nói rõ ranh giới quyền riêng tư ở đây: video và âm thanh được phiên âm cục bộ bằng faster-whisper, còn tài liệu, PDF và ảnh được gửi cho mô hình của trợ lý để trích xuất ngữ nghĩa. Với chạy không giao diện, cần cấu hình khóa API của một nhà cung cấp, hoặc một phiên Ollama cục bộ, hoặc thông tin AWS cho Bedrock, hoặc chính tệp thực thi claude.
Có nhiều phần mở rộng tùy chọn cài riêng. README liệt kê các extra như pdf, office cho docx và xlsx, video, mcp cho máy chủ MCP qua stdio, neo4j, falkordb, svg, leiden, các backend như ollama, openai, gemini, anthropic, bedrock và azure, cùng nhiều bộ trích xuất ngôn ngữ chuyên biệt như sql, terraform, pascal, ocaml, commonlisp và robot. Có một extra tên all để cài tất cả.
Dự án cũng hỗ trợ các thiết lập dùng chung nhóm. Có thể commit hoặc chia sẻ đồ thị để cả nhóm truy vấn cùng một ngữ cảnh, và dùng đồ thị để xem xét pull request. Một file .graphifyrc đặt ở thư mục gốc quét cho phép khai báo những thiết lập thuộc về dự án, ví dụ ý nghĩa của các đuôi file mơ hồ như .h, .inc hay .m, vì README cảnh báo rằng đoán sai ngôn ngữ khiến đồ thị trông đầy đủ nhưng thiếu các ký hiệu thật.
Cài đặt và dùng thử
README mô tả phần bắt đầu mất khoảng 30 giây và cần Python 3.10 trở lên cùng uv, hoặc pipx như phương án thay thế. Có lưu ý quan trọng về tên gói: gói chính thức trên PyPI là graphifyy với hai chữ y, còn các gói graphify khác trên PyPI không có liên quan. Lệnh chạy vẫn là graphify. README cũng nêu rõ kho mã chính thức là Graphify-Labs/graphify, điều đáng nhớ để tránh cài nhầm gói giả mạo.
Sau khi cài, người dùng chạy graphify install một lần. Lệnh này nhận diện trợ lý đang dùng và đăng ký skill, nên không cần thiết lập riêng cho từng trợ lý. Sau đó mở trợ lý AI và gõ lệnh graphify kèm đường dẫn dự án. Riêng Codex dùng ký hiệu đô la thay cho dấu gạch chéo. Nếu muốn cài skill vào chính repo thay vì hồ sơ người dùng, có thể thêm cờ project, khi đó các file được ghi dưới thư mục hiện tại, ví dụ trong thư mục skill của Claude hoặc của agents, và có thể commit.
Danh sách nền tảng được hỗ trợ khá dài, hơn 20 trợ lý, trên macOS, Linux và Windows: Claude Code, Cursor, Codex, Gemini CLI, GitHub Copilot, OpenCode, Kilo Code, Aider, OpenClaw, Factory Droid, Trae, Kiro, Amp, Devin CLI, Google Antigravity và nhiều tên khác. Mỗi nền tảng có lệnh cài riêng. README lưu ý Codex cần bật multi_agent trong cấu hình để trích xuất song song, còn OpenClaw và Aider dùng trích xuất tuần tự vì hỗ trợ agent song song ở đó còn sớm.
Để gỡ cài đặt, có lệnh graphify uninstall cho tất cả nền tảng cùng lúc, thêm cờ purge nếu muốn xóa luôn thư mục graphify-out. Phần xử lý sự cố và hướng dẫn chi tiết được README dẫn sang tài liệu riêng. Bản README được thu thập kết thúc bằng một mục Troubleshooting chỉ nhắc đến các lỗi cài đặt và trích xuất thường gặp, nên ở đây không có thêm chi tiết nào để tóm tắt.
Dùng trong workflow của AI agent
Giá trị thực tế nhất nằm ở việc buộc trợ lý luôn tham khảo đồ thị. Sau khi dựng đồ thị, chạy graphify install trong dự án, ví dụ graphify claude install hoặc graphify codex install, sẽ ghi một file cấu hình nhỏ bảo trợ lý hãy hỏi đồ thị cho các câu hỏi về codebase, ưu tiên truy vấn hẹp bằng graphify query thay vì đọc cả báo cáo hoặc grep file thô.
Cách ép này khác nhau theo nền tảng. Với Claude Code và Gemini CLI, README cho biết một hook chạy tự động trước các lệnh kiểu tìm kiếm, và trên Claude Code còn trước khi đọc từng file mã bằng công cụ Read hoặc Glob, để nhắc trợ lý đi đường đồ thị. Với Codex, OpenCode, Cursor và các nền tảng khác, các file chỉ dẫn lâu dài như AGENTS.md hoặc quy tắc của Cursor cung cấp hướng dẫn tương tự, ưu tiên truy vấn trước. Báo cáo GRAPH_REPORT.md vẫn dùng được khi cần duyệt kiến trúc tổng thể.
README cũng phân biệt hai cách tích hợp: kỹ năng và CLI cục bộ, hoặc máy chủ MCP đã kết nối. Với cách đầu, chỉ dẫn do graphify install ghi ra, và agent chạy graphify query, path, explain trên đồ thị cục bộ. Với cách sau, chỉ dẫn và công cụ do chính kết nối MCP cung cấp. Lệnh graphify install chỉ cài tích hợp trợ lý cục bộ chứ không tạo kết nối MCP. Nếu dùng cả hai, README khuyên chọn một đường truy vấn chính và xác định đồ thị nào mỗi bên đang hỏi, thay vì dán cả hai khối chỉ dẫn vô điều kiện vào AGENTS.md.
Với người xây agent, điều này gợi ra một mẫu thiết kế: đưa cấu trúc dự án vào một lớp tri thức có thể truy vấn, tách khỏi cửa sổ ngữ cảnh. README khẳng định hướng này giúp agent hỏi thay vì đọc, tuy nhiên chúng tôi chỉ dựa vào mô tả của README và chưa tự kiểm chứng mức tiết kiệm trong thực tế.
Số liệu benchmark do tác giả công bố
README có một bảng benchmark do chính tác giả công bố, đặt tiêu đề là 0.497 recall@10 với 0 tín dụng LLM. Trên LOCOMO với 300 mẫu, recall@10 của Graphify là 0.497, so với mem0 là 0.048 và supermemory là 0.149. Cũng trên LOCOMO, độ chính xác hỏi đáp là 45.3%, trong khi supermemory đạt 49.7% và mem0 đạt 27.3%. Nghĩa là ở chỉ số này Graphify không dẫn đầu, và README cũng ghi đúng như vậy.
Trên LongMemEval-S với 50 mẫu, độ chính xác hỏi đáp là 76%, ngang với dense RAG. Trên bài kiểm tra ERPNext liên công cụ với 6 mẫu, độ phủ sự kiện chính là 82.0%, so với đường cơ sở grep và đọc file là 70.8%. Với việc dựng đồ thị, số tín dụng LLM là 0, trong khi tác giả nói phần lớn hệ thống khác tính phí theo token.
Tác giả nêu rằng mọi hệ thống chạy trên cùng một bộ khung với cùng mô hình và ngân sách, và điểm số do một giám khảo chấm, được kiểm tra mù với giám khảo thứ hai, đạt mức đồng thuận 90.6% và hệ số kappa Cohen là 0.81. Bảng đầy đủ, kết quả về trí tuệ mã và lệnh tái hiện nằm trong BENCHMARKS.md.
Cần đọc các con số này đúng ngữ cảnh. Đây là số liệu tự công bố, cỡ mẫu của vài bài kiểm tra khá nhỏ, và chúng tôi không tự chạy lại. Người đánh giá nghiêm túc nên tái hiện bằng lệnh trong tài liệu của tác giả, trên dữ liệu gần với dự án của mình, trước khi dựa vào chúng.
Quyền riêng tư và những điều cần lưu ý
Về quyền riêng tư, README liệt kê rõ từng loại dữ liệu. Mã nguồn được xử lý cục bộ bằng tree-sitter và không rời khỏi máy; một corpus chỉ có mã không cần khóa API và graphify extract chạy hoàn toàn ngoại tuyến. Với repo hỗn hợp có thể thêm cờ code-only để chỉ lập chỉ mục mã. Tài liệu, PDF và ảnh được gửi tới mô hình của trợ lý hoặc backend đã cấu hình. README nêu không có telemetry, không theo dõi sử dụng và không có phân tích.
Với dữ liệu có yêu cầu lưu trú dữ liệu, README khuyên đặt backend là ollama để chạy hoàn toàn cục bộ, hoặc đặt GRAPHIFY_BACKEND thành none để tắt mọi backend LLM và giữ đồ thị chỉ có mã. README cũng cảnh báo khóa của Kimi định tuyến tới máy chủ Moonshot AI ở Trung Quốc. Khi tự phát hiện nhà cung cấp, công cụ in ra biến môi trường đã quyết định lựa chọn, nên người dùng không bị bất ngờ.
Một chi tiết dễ bị bỏ qua là nhật ký truy vấn. Mỗi lệnh query, path, explain và mỗi lần gọi query_graph qua MCP được ghi vào một file nhật ký định dạng JSON Lines trong thư mục cache của người dùng, gồm thời điểm, câu hỏi, corpus, số nút trả về và thời lượng. Toàn bộ đồ thị con trả về không được lưu mặc định. Có thể tắt bằng biến GRAPHIFY_QUERY_LOG_DISABLE đặt là 1.
Cũng cần lưu ý rằng README mở đầu bằng nhiều lời quảng bá cho Graphify Cloud, một dịch vụ trả phí có dùng thử miễn phí 14 ngày với các tuyên bố như giảm chi tiêu token của agent 80%. Đó là phần thương mại của nhóm tác giả và là tuyên bố do họ tự đưa ra; bản mã nguồn mở mô tả trong bài này là phần chạy cục bộ. README không nói chi tiết cách Graphify Cloud đạt được mức đó nên chúng tôi không đánh giá nó.
Khi nào nên và không nên dùng
Graphify hợp với những dự án có nhiều file, nhiều ngôn ngữ hoặc nhiều tài liệu đi kèm mà agent hay phải khám phá lại từ đầu: monorepo, hệ thống cũ cần làm quen, hay codebase có ADR và RFC. Nếu bạn muốn một lớp truy vấn có thể giải thích được, nơi mỗi cạnh nói rõ là đọc trực tiếp hay suy luận, và muốn phần mã không rời khỏi máy, thiết kế của nó khá phù hợp.
Nó cũng hợp khi nhóm dùng nhiều trợ lý khác nhau. README nói một lần cài dùng được cho hơn 20 trợ lý, nên đồ thị và chỉ dẫn truy vấn có thể nhất quán giữa các công cụ, và việc chia sẻ đồ thị trong nhóm giúp mọi người hỏi cùng một ngữ cảnh.
Ngược lại, với dự án nhỏ vài file, chi phí thiết lập và thêm một lớp cấu hình cho trợ lý có thể không đáng. Nếu phần lớn giá trị của bạn nằm ở tài liệu, PDF và ảnh thay vì mã, hãy nhớ rằng phần đó cần một lượt trích xuất ngữ nghĩa qua mô hình, tức là có chi phí và dữ liệu rời khỏi máy trừ khi bạn dùng backend cục bộ. Cần chú ý chọn đúng tên gói graphifyy khi cài.
Cuối cùng, README chưa mô tả đầy đủ ở phần giới thiệu về giới hạn của việc phân giải quan hệ suy luận, về độ chính xác trên từng ngôn ngữ, hay cách đồ thị được cập nhật khi mã thay đổi, mà dẫn sang tài liệu riêng. Vì vậy trước khi đưa vào quy trình chính thức, nên thử trên một dự án thật, đọc các tài liệu Supported inputs và How it works, và đối chiếu các nhãn INFERRED với mã thực tế.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.