03 / AI REPO RADAR
firecrawl/firecrawl
195.040 sao+2.589 / 7 ngàyLicense: AGPL-3.0Push gần nhất: Lên radar:
API mã nguồn mở để tìm kiếm, thu thập và tương tác với web, trả về markdown hoặc JSON có cấu trúc cho agent; kết nối qua skill, CLI, MCP và nhiều SDK.
Firecrawl là gì và giải quyết vấn đề nào
Firecrawl tự giới thiệu là API để tìm kiếm, thu thập và tương tác với web ở quy mô lớn, và gọi mình là context API dành cho AI agent. README cho biết dự án là mã nguồn mở và cũng có bản dịch vụ lưu trữ sẵn. Mô tả ngắn trên GitHub là giúp agent của bạn có dữ liệu từ web và hơn thế nữa.
Vấn đề dự án nhắm tới rất quen thuộc với người xây agent: trang web đầy JavaScript, bị chặn, giới hạn tần suất, và HTML thô tốn nhiều token. Firecrawl nhận một địa chỉ hoặc một câu truy vấn rồi trả về nội dung sạch, sẵn sàng cho mô hình ngôn ngữ, ví dụ markdown, JSON có cấu trúc hoặc ảnh chụp màn hình. README mô tả đây là cách để tiêu ít token hơn và xây ứng dụng AI tốt hơn.
Theo thông tin lấy từ GitHub, repo có 195040 sao và giấy phép được ghi là AGPL-3.0. Lần đẩy mã gần nhất là ngày hai mươi lăm tháng mười năm hai nghìn hai trăm hai mươi sáu. Các con số này chỉ cho thấy mức quan tâm của cộng đồng. Phần còn lại của bài dựa hoàn toàn vào README do tác giả viết, và nhiều tuyên bố hiệu năng trong đó là do chính tác giả công bố.
Những điểm mà tác giả nhấn mạnh
Mục vì sao nên dùng Firecrawl liệt kê tám điểm. Về độ tin cậy, tác giả nói bao phủ 96% của web, kể cả các trang nặng JavaScript, không cần đau đầu về proxy. Về tốc độ, tác giả công bố độ trễ P95 là 3.4s trên hàng triệu trang, hướng tới agent thời gian thực. Cả hai đều là số liệu do tác giả tự công bố, README dẫn tới phần benchmark riêng nhưng nội dung benchmark không nằm trong README này.
Về đầu ra, dự án nói trả về markdown sạch, JSON có cấu trúc, ảnh chụp màn hình và nhiều định dạng khác. Về phần việc khó, dự án nói tự xử lý proxy xoay vòng, điều phối, giới hạn tần suất và nội dung bị chặn bằng JavaScript mà không cần cấu hình. Về agent, chỉ cần một lệnh để nối Firecrawl với bất kỳ agent hoặc client MCP nào.
Các điểm còn lại gồm phân tích tài liệu, biến PDF, DOCX và các tài liệu khác thành markdown sạch hoặc JSON có cấu trúc; các hành động như nhấp chuột, cuộn, gõ, chờ và nhấn phím trước khi trích xuất nội dung; và tính mã nguồn mở, phát triển công khai và hợp tác. Hãy đọc những dòng này như lời giới thiệu của tác giả chứ không phải kết quả kiểm chứng độc lập.
Các endpoint chính
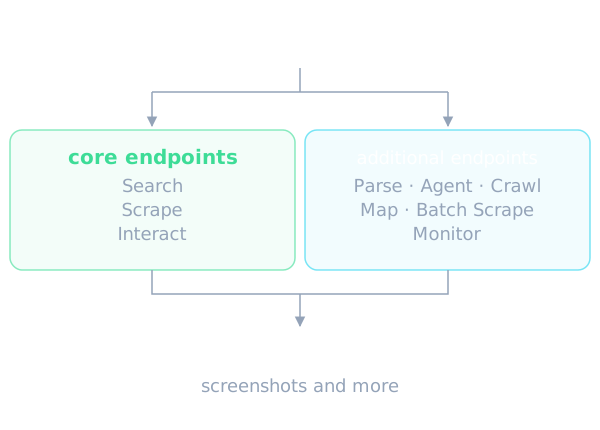
README chia tính năng thành nhóm endpoint cốt lõi và nhóm bổ sung. Nhóm cốt lõi có ba endpoint. Search tìm kiếm trên web và trả về toàn bộ nội dung trang trong kết quả. Scrape chuyển bất kỳ địa chỉ nào thành markdown, HTML, ảnh chụp màn hình hoặc JSON có cấu trúc. Interact thu thập một trang rồi cho phép tương tác với trang đó bằng prompt AI hoặc bằng mã.
Nhóm bổ sung có thêm sáu mục. Parse biến PDF, DOCX và các tài liệu khác thành markdown sạch hoặc JSON có cấu trúc. Agent là cách thu thập dữ liệu tự động, bạn chỉ cần mô tả điều muốn lấy. Crawl thu thập mọi địa chỉ của một website chỉ bằng một yêu cầu. Map khám phá tất cả địa chỉ trên một website gần như tức thì. Batch Scrape thu thập hàng nghìn địa chỉ một cách bất đồng bộ. Monitor báo cho bạn khi nội dung trên một website thay đổi.
Với mỗi endpoint trong phần khởi động nhanh, README cho thấy ví dụ bằng Node.js, cURL và giao diện dòng lệnh, kèm phần đầu ra. Phần mã ví dụ không nằm trong bản README đã được làm sạch, nên bài này không mô tả cú pháp cụ thể; bạn cần xem README gốc hoặc tài liệu API để biết tham số.
Endpoint Agent và các mức nỗ lực
Endpoint Agent được README mô tả là cách dễ nhất để lấy dữ liệu từ web: bạn mô tả cần gì, và tác nhân AI của Firecrawl sẽ tìm kiếm, điều hướng và lấy về, không cần biết trước địa chỉ. README cho biết Agent là bản phát triển tiếp theo của endpoint extract trước đây, nhanh hơn, đáng tin cậy hơn và không đòi hỏi bạn biết địa chỉ từ đầu.
Có hai biến thể nâng cao. Một là đầu ra có cấu trúc: bạn đưa vào một schema để nhận dữ liệu theo đúng khuôn. Hai là tùy chọn truyền địa chỉ: nếu muốn, bạn có thể hướng agent vào những trang cụ thể thay vì để nó tự tìm.
README còn có mục chọn mức nỗ lực. Mức thấp phù hợp với tra cứu đơn giản trên một trang web. Mức trung bình phù hợp với tác vụ nhiều bước trên vài trang. Mức cao phù hợp với nghiên cứu sâu, điều hướng phức tạp và dữ liệu quan trọng. Theo README, mọi mức nỗ lực đều chạy mô hình spark-2; mức nỗ lực chỉ đổi ngân sách suy luận chứ không đổi mô hình. Các tên spark-1-pro và spark-1-mini đã bị loại bỏ nhưng vẫn được chấp nhận vì tương thích ngược, và cũng chạy spark-2.
Crawl, Map và Batch Scrape
Crawl dùng khi bạn muốn lấy nội dung của cả một website. README cho biết lệnh trả về một mã công việc, sau đó bạn kiểm tra trạng thái của công việc đó. Có một ghi chú hữu ích: các SDK tự xử lý việc hỏi lại trạng thái, nên trải nghiệm lập trình gọn hơn so với tự viết vòng lặp.
Map khám phá các địa chỉ của một website và có một biến thể tìm kiếm để tìm các địa chỉ cụ thể trong trang. Batch Scrape thu thập nhiều địa chỉ cùng lúc. Ba endpoint này bổ trợ cho nhau: Map để biết site có những gì, Crawl để lấy toàn bộ, Batch Scrape khi bạn đã có sẵn danh sách địa chỉ.
README không nêu giới hạn về độ sâu, số trang hay tốc độ cho các endpoint này, cũng không nói về chính sách tính phí theo từng loại yêu cầu trong phần mô tả. Nếu bạn định dùng với khối lượng lớn, cần đọc tài liệu API và trang giá của dịch vụ.
Cách kết nối với agent: skill, CLI và MCP
Phần Power Your Agent là nơi dự án nói trực tiếp với người xây agent. Có hai đường chính. Đường thứ nhất là skill: chỉ với một lệnh, bạn cho agent quyền truy cập dữ liệu web thời gian thực; sau khi cài cần khởi động lại agent. README nói cách này hoạt động với Claude Code, Antigravity, OpenCode và nhiều agent khác. Đường thứ hai là MCP: bất kỳ client nào tương thích MCP đều kết nối được với web trong vài giây, và README trỏ tới một kho riêng cho máy chủ MCP.
Có thêm một mục khá độc đáo là Agent Onboarding, viết cho chính AI agent: nếu bạn là một agent, hãy lấy skill này để đăng ký giúp người dùng, lấy khóa API và bắt đầu xây với Firecrawl. Tức là dự án coi agent là một nhóm người dùng đầu tiên cần được hướng dẫn riêng.
Phần tích hợp nhắc tới danh mục skill của Firecrawl cài bằng một lệnh, giao diện dòng lệnh Firecrawl, và MCP của Firecrawl. README cũng giải thích cách đóng góp skill: skill dùng CLI gửi vào kho cli, skill tích hợp SDK vào mã sản phẩm thì gửi vào chính repo này trong thư mục skills, còn skill quy trình làm việc gửi vào kho workflows. Danh mục skill là chỉ đọc và không nhận pull request trực tiếp. Về nền tảng, README liệt kê Lovable, Zapier và n8n.
SDK và ngôn ngữ được hỗ trợ
README cho biết các SDK giúp dùng đủ tính năng của Firecrawl và tự xử lý việc hỏi lại trạng thái với tác vụ bất đồng bộ. Danh sách ngôn ngữ khá dài: Python, Node.js, Go, Java, Elixir, Rust, Ruby, .NET và PHP. Với mỗi ngôn ngữ, README có mục hướng dẫn cài SDK hoặc thêm phụ thuộc.
Với người xây agent, độ phủ ngôn ngữ này có ích vì đội ngũ thường dùng nhiều ngôn ngữ khác nhau cho dịch vụ phía sau. Tuy vậy README không nói SDK nào ổn định hơn, hay tính năng nào có mặt ở SDK nào. Giấy phép cũng cần lưu ý: README nói các SDK và một số thành phần giao diện theo giấy phép MIT, trong khi phần lớn dự án theo AGPL-3.0.
Mã nguồn mở và bản đám mây
Firecrawl được phát hành mã nguồn mở theo giấy phép GNU Affero General Public License phiên bản AGPL-3.0, còn bản đám mây có thêm một số tính năng. Danh sách tính năng bổ sung đó không nằm trong bản README đã làm sạch, nên không thể nêu cụ thể. Để chạy cục bộ README trỏ tới hướng dẫn đóng góp, và để tự lưu trữ thì có hướng dẫn tự lưu trữ riêng.
Điểm này quan trọng khi chọn cách triển khai. Tự lưu trữ cho bạn quyền kiểm soát, nhưng giấy phép AGPL có nghĩa vụ riêng khi bạn cung cấp dịch vụ qua mạng, và bạn nên đọc kỹ điều khoản. Bản đám mây thuận tiện hơn nhưng bạn cần khóa API và phụ thuộc vào nhà cung cấp. README không so sánh chi tiết hai hướng này.
Giới hạn, lưu ý và khi nào nên dùng
README nêu một lưu ý pháp lý rõ ràng: người dùng cuối hoàn toàn chịu trách nhiệm tuân thủ chính sách của các website khi thu thập dữ liệu, và nên tuân thủ chính sách riêng tư cùng điều khoản sử dụng hiện hành. Theo mặc định Firecrawl tôn trọng chỉ thị robots.txt. Nếu agent của bạn thu thập dữ liệu tự động, đây là phần cần đưa vào quy trình rà soát.
Những điều README không nói gồm: chi phí theo mức dùng, hạn mức miễn phí, giới hạn tần suất cụ thể, cách benchmark 96% được đo, và cách xử lý trang cần đăng nhập. Các số liệu hiệu năng đều do tác giả tự công bố. Vì nội dung bài dựa trên README, hãy xác minh các endpoint và tên mô hình hiện hành trong tài liệu trước khi dùng, nhất là khi README ghi một số tên đã bị loại bỏ.
Firecrawl hợp nếu agent của bạn cần dữ liệu web sạch và có cấu trúc, cần tìm kiếm cộng với đọc toàn văn, hoặc cần biến PDF và DOCX thành markdown. Nó ít hợp nếu bạn cần giải pháp thuần mã nguồn mở không điều kiện về giấy phép, hoặc nếu dữ liệu của bạn nằm sau đăng nhập mà README chưa đề cập. Cách thực tế nhất là cài skill hoặc MCP, thử vài trang mẫu và đo chất lượng đầu ra trên nội dung của chính bạn trước khi cam kết.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.