03 / AI REPO RADAR
vectorize-io/hindsight
53.775 sao+2.072 / 7 ngàyLicense: MITPush gần nhất: Lên radar:
Hệ thống bộ nhớ cho agent của Vectorize: lưu sự kiện, gom thành niềm tin có bằng chứng và mô hình tinh thần để agent học dần theo thời gian thay vì chỉ nhớ lại hội thoại.
Hindsight là gì và giải quyết vấn đề nào
Hindsight là một hệ thống bộ nhớ dành cho agent AI, do Vectorize phát triển và phát hành theo giấy phép MIT. Theo phần mô tả đầu README, mục tiêu của dự án là tạo ra những agent thông minh hơn theo thời gian, tức là agent biết học chứ không chỉ biết nhớ. Đây là điểm khác biệt mà tác giả nhấn mạnh ngay từ câu đầu tiên.
README cho rằng phần lớn hệ thống bộ nhớ cho agent hiện nay tập trung vào việc gọi lại lịch sử hội thoại. Hindsight muốn đi xa hơn: tác giả nói nó loại bỏ những hạn chế của các kỹ thuật thay thế như RAG và đồ thị tri thức, và đạt hiệu năng hàng đầu trên các tác vụ bộ nhớ dài hạn. Đây là lời tự công bố của tác giả, bạn nên kiểm tra lại trên dữ liệu của mình trước khi tin.
Về mức độ phổ biến, metadata ghi nhận repo có 53775 sao, tăng 2072 sao trong bảy ngày gần nhất, và lần đẩy mã gần nhất vào ngày 25 tháng 10 năm 2026. Những con số này chỉ cho thấy sự quan tâm của cộng đồng, không chứng minh chất lượng, nhưng đủ để xem đây là dự án đang hoạt động tích cực.
Hiệu năng và độ chính xác theo công bố của tác giả
README có hẳn một mục về hiệu năng và độ chính xác của bộ nhớ. Tác giả khẳng định Hindsight là hệ thống bộ nhớ agent chính xác nhất từng được thử nghiệm dựa trên benchmark, và đạt kết quả hàng đầu trên LongMemEval, một benchmark được dùng rộng rãi để đánh giá hệ thống bộ nhớ trong nhiều kịch bản AI hội thoại. Mốc so sánh trong README là tháng 1 năm 2026.
README nói dữ liệu benchmark của Hindsight đã được các cộng sự nghiên cứu tại Virginia Tech Sanghani Center for Artificial Intelligence and Data Analytics và The Washington Post tái lập độc lập, trong khi điểm số của các hệ thống khác là do chính nhà cung cấp tự báo cáo. Đây vẫn là thông tin do tác giả viết ra, README không đính kèm số liệu cụ thể trong phần văn bản mà chúng tôi có, nên bài này không trích dẫn con số điểm nào.
README cũng cho biết kết quả cập nhật liên tục, gồm độ chính xác theo từng mô hình, độ trễ và chi phí, được đăng trên một trang benchmark riêng của dự án. Ngoài ra tác giả nói Hindsight đang chạy production tại các doanh nghiệp thuộc nhóm Fortune 500 và tại một số startup AI. README không nêu tên khách hàng hay quy mô, nên đây chỉ nên xem là thông tin tham khảo.
Các loại bộ nhớ: sự kiện thế giới, trải nghiệm, quan sát và mô hình tinh thần
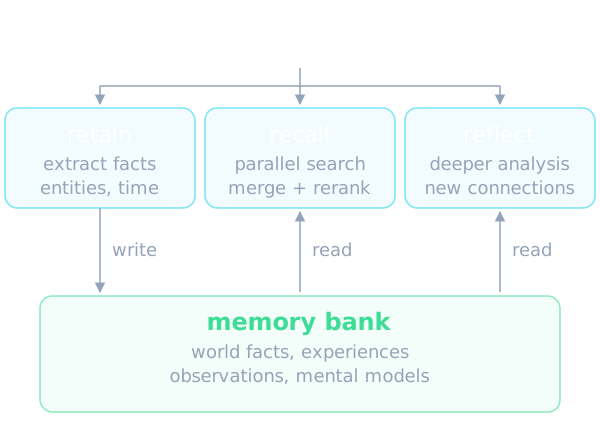
Thay vì chỉ dùng tìm kiếm vector hoặc đồ thị tri thức, Hindsight nói rằng nó dùng các cấu trúc dữ liệu mô phỏng sinh học để tổ chức ký ức theo cách gần với trí nhớ con người hơn. README chia ký ức thành bốn loại: sự kiện về thế giới, ví dụ bếp lò thì nóng; trải nghiệm của chính agent, ví dụ tôi chạm vào bếp lò và bị đau; quan sát; và mô hình tinh thần.
Quan sát là những niềm tin đã được hợp nhất và có bằng chứng, hình thành từ nhiều ký ức khác nhau. Mô hình tinh thần là hiểu biết đã học về thế giới của agent, được tổng hợp từ quan sát và sự kiện. Cách phân tầng này cho phép agent không chỉ giữ lại dữ kiện thô mà còn giữ những kết luận rút ra từ chúng.
Khi ký ức được thêm vào, hệ thống đẩy chúng vào nhánh sự kiện thế giới hoặc nhánh trải nghiệm, rồi biểu diễn dưới dạng kết hợp của thực thể, quan hệ và chuỗi thời gian, cùng với biểu diễn vector thưa và dày để hỗ trợ truy xuất sau này. Mọi ký ức nằm trong các bank, khái niệm sẽ được nói ở phần sau.
Ba thao tác cốt lõi: retain, recall và reflect
Retain là thao tác đưa ký ức mới vào Hindsight. README mô tả rằng phía sau, retain dùng một mô hình ngôn ngữ để trích xuất các sự kiện chính, dữ liệu thời gian, thực thể và quan hệ, rồi chuẩn hóa thành thực thể chuẩn, chuỗi thời gian và chỉ mục tìm kiếm cùng metadata. Những biểu diễn này tạo đường dẫn cho recall và reflect hoạt động chính xác.
Recall là thao tác truy xuất ký ức, có thể lấy từ bất kỳ loại ký ức nào. README nói recall chạy song song 4 chiến lược truy xuất: ngữ nghĩa dựa trên độ tương đồng vector, từ khóa khớp chính xác theo BM25, đồ thị dựa trên liên kết thực thể, thời gian và nhân quả, và lọc theo khoảng thời gian. Kết quả của các chiến lược được gộp lại, sắp xếp bằng reciprocal rank fusion và một mô hình cross-encoder xếp hạng lại, sau đó cắt bớt để vừa giới hạn token.
Reflect là thao tác phân tích sâu hơn trên ký ức hiện có, cho phép agent tạo liên kết mới giữa các ký ức hoặc trả lời câu hỏi cần suy nghĩ thay vì tra cứu. README đưa ba ví dụ: một AI quản lý dự án suy xét rủi ro cần giảm thiểu, một agent bán hàng tìm hiểu vì sao một số tin nhắn tiếp cận được phản hồi còn số khác thì không, và một agent hỗ trợ tìm ra những câu hỏi khách hàng mà tài liệu sản phẩm hiện tại chưa trả lời.
Quan sát, mô hình tinh thần và trang tri thức
README nhấn mạnh rằng các sự kiện được lưu không nằm yên thành một đống phẳng. Chạy nền, Hindsight hợp nhất các sự kiện liên quan thành quan sát, tức là những niềm tin đã khử trùng lặp mà bank tích lũy theo thời gian. Mỗi quan sát giữ bằng chứng hỗ trợ kèm trích dẫn nguyên văn và số lượng bằng chứng, và được tinh chỉnh chứ không bị ghi đè khi có bằng chứng mới. Nhờ vậy thông tin mới có thể củng cố, làm yếu hoặc mở rộng một niềm tin có sẵn thay vì lặng lẽ thay thế nó.
Mô hình tinh thần là một câu trả lời thường trực cho một câu hỏi về bank, ví dụ sở thích của người dùng này là gì. Bạn định nghĩa câu hỏi một lần, Hindsight viết câu trả lời, lưu lại và tự viết lại ở chế độ nền khi bank học thêm. README nói đọc một mô hình tinh thần chỉ là một lần đọc cơ sở dữ liệu, không cần truy xuất hay gọi mô hình ngôn ngữ, nên agent có thể khởi động với một trang kiến thức đã ổn định thay vì khám phá lại mọi phiên.
Trang tri thức là các mô hình tinh thần được giấu bớt cơ chế bên dưới: những tài liệu sống mà bank tự viết về chính nó, sắp xếp theo thư mục như một wiki, có thể tìm kiếm và có thể xuất ra đĩa dưới dạng markdown thông thường. Bạn chỉ cần cung cấp tên và câu hỏi, mọi quyết định khác đều là giá trị mặc định có thể ghi đè.
Bank, tính đa ngôn ngữ và Memory Defense
Bank là một kho ký ức cô lập, có thể xem như một bộ não riêng cho một người dùng, một agent hoặc một dự án. README nói sự cô lập là nghiêm ngặt, không có rò rỉ giữa các bank. Mỗi bank mang theo bối cảnh nền và các đặc điểm tính cách như mức hoài nghi, mức diễn giải nghĩa đen và mức đồng cảm, những đặc điểm này định hình cách reflect suy luận trên ký ức, và bank có thể được tạo từ các mẫu khai báo.
Hindsight được mô tả là đa ngôn ngữ theo mặc định. Ngôn ngữ đầu vào được nhận diện và giữ nguyên xuyên suốt, sự kiện giữ ngôn ngữ gốc và thực thể giữ chữ viết bản địa. README lấy ví dụ tên viết bằng chữ Hán vẫn được giữ nguyên chứ không bị phiên âm sang chữ Latin.
Memory Defense là chính sách tùy chọn theo từng bank. Mỗi lần retain, hệ thống quét bí mật và thông tin cá nhân nhạy cảm theo 45 mẫu, rồi hoặc che phần khớp, hoặc chặn mục đó trước khi nó chạm tới lớp lưu trữ. Với agent xử lý dữ liệu người dùng thật, đây là lớp phòng vệ đáng cân nhắc, nhưng vì là tùy chọn nên bạn phải chủ động bật.
Cài đặt và dùng thử
README đưa ra nhiều đường cài đặt. Cách được khuyến nghị là Docker, với một API và một giao diện web. Ngoài ra có Docker kết nối PostgreSQL bên ngoài, cài bare metal bằng pip, triển khai trên Kubernetes bằng Helm, và một dịch vụ được quản lý là Hindsight Cloud, nơi bạn trỏ client tới dịch vụ bằng khóa API và bỏ qua hoàn toàn việc tự vận hành. README cho biết Cloud tính phí theo mức sử dụng, có tín dụng miễn phí ban đầu, không có phí cố định theo tháng hay theo chỗ ngồi, và cam kết 99.9 phần trăm thời gian hoạt động.
Hindsight dùng mô hình ngôn ngữ cho các bước như retain, và README nói nó hoạt động với hơn 25 nhà cung cấp, chọn qua một biến môi trường. Danh sách gồm các dịch vụ đám mây, các lựa chọn chạy hoàn toàn cục bộ như ollama, lmstudio và llamacpp, mọi endpoint tương thích OpenAI, và các cổng trung gian như litellm. Một số gói thuê bao sẵn có như ChatGPT Plus hoặc Pro, Claude Pro hoặc Max, Cursor và GitHub Copilot cũng dùng được mà không cần khóa API.
Về client, README liệt kê Python, Node.js hoặc TypeScript, Go, CLI và REST API. Bảng nền tảng hỗ trợ cho thấy Linux, macOS Apple Silicon và Windows đều chạy được với Docker, pip và cơ sở dữ liệu nhúng pg0. Riêng máy Mac Intel, cài bằng pip có cảnh báo và README hướng dẫn dùng gói hindsight-all-slim. Ngoài ra có chế độ nhúng cho Python không cần chạy server riêng, và một bản tương đương cho Node.js cùng một CLI chạy nền.
Dùng Hindsight trong workflow của agent
Cách nhanh nhất để thêm bộ nhớ cho một agent có sẵn là LLM Wrapper. Bạn thay client mô hình ngôn ngữ bằng phiên bản được bọc, và ký ức sẽ được lưu rồi truy xuất tự động ở mỗi lần gọi mà không phải sửa gì khác trong mã. README nói có wrapper tương ứng cho Anthropic SDK, và mọi thiết lập như bank, ngân sách recall, loại sự kiện, hoặc dùng reflect thay vì recall đều có thể ghi đè theo từng lần gọi. LiteLLM nằm bên dưới nên cùng cách tích hợp này bao phủ hơn 100 mô hình. Nếu cần kiểm soát chính xác thời điểm lưu và truy xuất, README khuyên dùng trực tiếp SDK hoặc REST API.
README tuyên bố có hơn 60 tích hợp, phần lớn không cần sửa mã. Nhóm coding agent gồm Claude Code, Codex, Cursor, GitHub Copilot, opencode, Cline, Aider, Zed, Continue, Roo Code và OpenHands. Nhóm framework agent gồm LangGraph và LangChain, LlamaIndex, CrewAI, Pydantic AI, OpenAI Agents SDK, Google ADK, Agno, Strands, AutoGen, Microsoft Agent Framework, Vercel AI SDK và Haystack. Còn có n8n, Zapier, Dify, Flowise, cùng ChatGPT, Perplexity, Obsidian, Pipecat và Vapi.
Với coding agent dùng trên dòng lệnh, README mô tả một gói giúp có trí nhớ dự án dài hạn: một bank riêng cho từng repo được dựng tự động từ lịch sử git và các phiên làm việc trước, được đưa vào agent khi nó bắt đầu làm việc, kèm các trang tri thức về kiến trúc, quy ước và công việc đang dở. Việc nạp dữ liệu là tự động, không có lệnh thiết lập. Ngoài ra mỗi server có sẵn một endpoint Model Context Protocol cho từng bank, bật mặc định, để mọi MCP client dùng retain, recall và reflect như các công cụ.
Vận hành thực tế
Phần Running in Production của README tóm tắt các thành phần vận hành. Lưu trữ dùng PostgreSQL với pgvector, hoặc Oracle AI Database 23ai với đầy đủ tính năng tương đương. Cấu hình theo thứ bậc từ biến môi trường toàn cục xuống từng tenant rồi từng bank. Giám sát dùng số liệu Prometheus và dashboard cho các lệnh gọi mô hình, token và độ trễ.
Về vận hành, có CLI quản trị cho di trú dữ liệu, sửa chữa bank và các tác vụ bị kẹt. Có webhook cho các sự kiện vòng đời của retain, hợp nhất và làm mới. Có điểm mở rộng cho tenant, xác thực và lưu trữ. Với những ai không muốn tự gánh việc này, tác giả hướng tới Hindsight Cloud. README không đi sâu vào chi tiết kiến trúc hay hiệu năng khi tải lớn, nên các câu hỏi về dung lượng, chi phí gọi mô hình và độ trễ thực tế cần được đo trên hệ thống của bạn.
Giới hạn và khi nào nên dùng
README tự nêu một giới hạn đáng chú ý: Hindsight phù hợp nhất với agent cần kết hợp nhiều tính năng, như nhân viên AI xử lý công việc mở, thay đổi hành vi theo phản hồi và học cách làm tác vụ phức tạp. Với các workflow AI đơn giản dựng bằng n8n và công cụ tương tự, tác giả nói Hindsight có thể là quá mức cần thiết. Ví dụ use case đơn giản nhất là cá nhân hóa chatbot theo từng người dùng, dùng metadata trong retain để cô lập ký ức rồi lọc khi truy xuất.
Một số điều README không nói rõ hoặc cần bạn tự kiểm chứng: số điểm benchmark cụ thể, chi phí gọi mô hình ngôn ngữ cho retain và reflect khi dữ liệu lớn, và chất lượng của quan sát được tạo tự động trên miền dữ liệu riêng của bạn. README cũng ghi bản quyền nhãn hiệu cho tên Hindsight và gắn dự án với Vectorize, nên nếu dùng dịch vụ Cloud bạn đang phụ thuộc một nhà cung cấp thương mại.
Tóm lại, nếu bạn đang xây agent cần nhớ lâu, học từ phản hồi và giữ tri thức qua nhiều phiên, Hindsight đáng để thử, nhất là khi bạn đã dùng sẵn một framework hay coding agent nằm trong danh sách tích hợp. Nếu agent của bạn chỉ chạy tác vụ ngắn, không trạng thái, một lớp bộ nhớ như thế này có thể chỉ làm tăng độ phức tạp. Cách an toàn là bắt đầu với Docker hoặc chế độ nhúng, thử LLM Wrapper trên một agent nhỏ, rồi tự đo chất lượng recall trước khi đưa vào production.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.