03 / AI REPO RADAR
Human-Agent-Society/reef
7.639 saoLicense: Apache-2.0Push gần nhất: Lên radar:
Hạ tầng mã nguồn mở cho agent tự cải thiện liên tục: phục vụ yêu cầu, ghi tương tác, ghép phản hồi, rồi cập nhật trọng số hoặc harness có quản lý phiên bản.
Reef là gì và giải quyết vấn đề nào
Reef là một dự án mã nguồn mở của nhóm Human-Agent-Society, được mô tả ngắn gọn là hạ tầng cho những agent liên tục tự cải thiện. Theo README, đây là hạ tầng mã nguồn mở đầu tiên dành cho kiểu agent học liên tục như vậy. Ý tưởng cốt lõi là nối bốn thứ vốn thường nằm rời nhau: suy luận của agent, phản hồi từ người dùng hoặc bộ chấm điểm, bước học, và việc phát hành các phiên bản đã được cập nhật.
Vấn đề mà Reef nhắm tới khá quen thuộc với người đã từng vận hành agent thật. Một agent chạy trong sản phẩm sinh ra rất nhiều tương tác, nhưng phần lớn chỉ nằm trong log và không bao giờ quay lại làm agent tốt hơn. Muốn cải thiện, nhóm phát triển thường phải tự dựng một quy trình riêng: gom dữ liệu, ghép phản hồi với từng lượt trả lời, chạy huấn luyện hoặc chỉnh prompt, đánh giá, rồi triển khai lại. Reef đóng gói chuỗi việc đó thành một hệ thống duy nhất có phiên bản rõ ràng.
README nói Reef dùng được theo hai hướng. Hướng thứ nhất là huấn luyện trọng số mô hình với Slime và SGLang. Hướng thứ hai là cải thiện phần harness của agent, tức prompt, các quy tắc và skill. Hai hướng này khác nhau nhiều về chi phí hạ tầng, và phần sau của bài sẽ nói rõ vì sao điều đó quan trọng khi bạn cân nhắc áp dụng.
Thông tin nền của repo
Theo metadata GitHub tại thời điểm thu thập, repo có 7639 sao và dùng giấy phép Apache-2.0. Mô tả chính thức của repo là hạ tầng cho agent liên tục tự cải thiện. Các chủ đề gắn kèm gồm agent-infrastructure, ai-agents, continual-learning, inference, llm, llm-training, reinforcement-learning và self-improving-agents, cho thấy dự án đứng ở giao điểm giữa vận hành agent và huấn luyện bằng học tăng cường.
Số sao cao không nói lên chất lượng kỹ thuật, nhưng cho thấy cộng đồng đang chú ý. README cũng liệt kê kênh Discord, nhóm WeChat, GitHub Discussions, hướng dẫn đóng góp, quy trình đề xuất thiết kế qua RFC và chính sách bảo mật để báo lỗ hổng riêng tư. Với một dự án hạ tầng còn mới, việc có sẵn các kênh này là tín hiệu tốt về mức độ mở của nhóm tác giả.
Khi nào nên dùng Reef
README đưa ra một bảng chọn đường học theo mục tiêu. Nếu bạn muốn một mô hình ngày càng mạnh và được thiết kế riêng cho mình, đường đi là huấn luyện trọng số mô hình, và bạn cần một mô hình có thể huấn luyện, một bộ GPU được hỗ trợ cùng loại phản hồi mà công thức huấn luyện của bạn dùng được. Nếu bạn muốn harness của agent tự cải thiện, đường đi là tối ưu harness, và bạn chỉ cần một endpoint mô hình, các tác vụ đại diện cùng một bộ đánh giá, không cần GPU huấn luyện cục bộ.
Hướng thứ ba trong bảng là khám phá khoa học bằng huấn luyện tại thời điểm kiểm thử. Hướng này cần một môi trường thực thi, một bộ kiểm tra tính đúng đắn và một mục tiêu đo được. Tóm lại, Reef đặt ra câu hỏi đầu tiên cho người dùng là agent của bạn sẽ học gì, trọng số, harness hay lời giải cho một bài toán khó, rồi mới đến chuyện cấu hình.
Đối với người xây agent ở quy mô nhỏ hoặc vừa, đường tối ưu harness có vẻ là điểm vào thực tế hơn vì không đòi hỏi hạ tầng GPU. README mô tả rõ rằng hướng này chỉ cần một API mô hình. Đây là nhận xét của người viết bài dựa trên bảng yêu cầu trong README, không phải khuyến nghị chính thức của tác giả.
Reef nằm ở đâu trong stack hiện có
README có một bảng so sánh Reef với hai nhóm công cụ quen thuộc. Nhóm thứ nhất là các engine suy luận như vLLM và SGLang. Nhóm thứ hai là các framework huấn luyện học tăng cường như Slime, veRL và AReaL. Engine suy luận phục vụ lưu lượng thật nhưng không huấn luyện trọng số. Framework huấn luyện thì ngược lại. Theo bảng, chỉ Reef cùng lúc phục vụ lưu lượng thật, huấn luyện trọng số, quản lý phiên bản, vẫn chạy liên tục khi cập nhật, và phát triển vượt ra ngoài trọng số sang skill và harness.
Cần đọc bảng này đúng cách: đó là cách tác giả tự định vị sản phẩm của mình, không phải một so sánh độc lập. Dù vậy, nó giúp hình dung vai trò. Reef không thay thế engine suy luận hay framework huấn luyện. README cũng ghi lời cảm ơn tới SGLang cho phần suy luận hiệu năng cao, slime cho phần huấn luyện trọng số và cordis cho phần tiến hóa harness, nghĩa là Reef dựa vào các dự án này cho những phần chuyên sâu.
Cách hoạt động: vòng học bốn bước
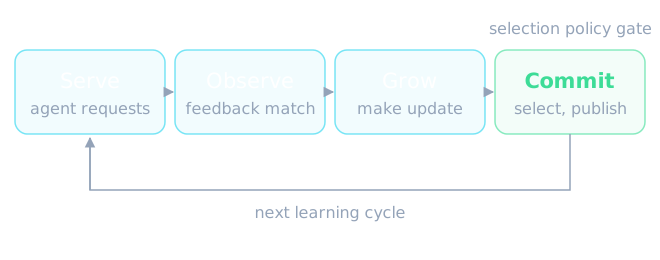
Mỗi chu kỳ học của Reef gồm bốn bước. Bước đầu là Serve: phục vụ các yêu cầu của agent và ghi lại tương tác. Bước hai là Observe: ghép phản hồi với những tương tác đã ghi. Bước ba là Grow: tạo ra một bản cập nhật từ các bản ghi đủ điều kiện. Bước bốn là Commit: áp dụng chính sách chọn lọc đã cấu hình và phát hành các bản cập nhật được chấp nhận.
README gắn từng bước với các thư mục mã nguồn. Phần phục vụ nằm ở service cho yêu cầu và bản ghi tương tác, và runtime cho suy luận cùng việc cập nhật artifact. Phần quan sát nằm ở storage cho tương tác và phản hồi đã lưu, và record2record cho việc ghép phản hồi cũng như xét điều kiện. Phần học nằm ở recipe cho việc tích hợp công thức, và train cho pipeline huấn luyện, các batch và job cập nhật. Phần chốt nằm ở evaluation cho việc đánh giá ứng viên, artifact cho lịch sử phiên bản, và surface cho việc giao artifact.
Điểm đáng chú ý là bước Commit có chính sách chọn lọc. Một bản cập nhật không tự động được đưa vào sử dụng chỉ vì nó vừa được tạo ra; nó phải đi qua đánh giá ứng viên trước. Với bất kỳ hệ thống tự cải thiện nào, đây là chỗ quyết định agent có tiến bộ thật hay chỉ thay đổi, nên người đọc nên xem kỹ phần evaluation khi đánh giá dự án.
Cài đặt và dùng thử
README hướng dẫn cài từ PyPI hoặc từ mã nguồn, và khuyên dùng uv để quản lý gói. Bản cài từ mã nguồn dành cho phát triển và cho các ví dụ huấn luyện. Có một lưu ý quan trọng: chức năng artifact và checkpoint của Reef cần gói hệ thống git-lfs, và Reef khởi tạo Git LFS cục bộ cho các kho artifact của nó.
Ví dụ tối giản nhất là chạy Reef như một máy chủ suy luận thuần. Từ đó, endpoint suy luận của Reef tương thích với OpenAI và Anthropic, nhận nguyên thân yêu cầu của nhà cung cấp ở các đường dẫn chat completions, responses và messages. Mỗi yêu cầu kèm một header chỉ định kịch bản; nếu dùng tên mới, Reef tạo một kịch bản mới theo công thức đã cấu hình của deployment. Yêu cầu không được chọn công thức.
Phản hồi của Reef giữ định dạng tương thích OpenAI và thêm một header chứa mã biên nhận của lượt tương tác. Về sau, báo cáo phản hồi dùng biên nhận này để chỉ ra lượt tương tác nào đang được chấm. Một báo cáo có thể chứa điểm số, phản hồi dạng văn bản hoặc có cấu trúc, và danh sách biên nhận được đánh giá. Endpoint kiểm tra báo cáo theo một schema riêng.
Hai kiểu triển khai: huấn luyện trọng số và tiến hóa harness
Với triển khai huấn luyện trọng số, README lấy ví dụ deployment SAO, gắn với bài báo mang mã arXiv 2607.07508. Ví dụ này cần chạy từ một bản checkout của Reef trong môi trường đáp ứng yêu cầu GPU. Bạn gửi yêu cầu suy luận qua Reef và báo điểm cho từng phản hồi; công thức SAO dùng mỗi lượt rollout đủ điều kiện có điểm để chạy một bước huấn luyện. Khi đủ phản hồi, công thức chạy bước huấn luyện và đồng bộ trọng số mới sang runtime phục vụ. Các yêu cầu sau đó dùng phiên bản hiện tại mà không cần khởi động lại Reef.
Với triển khai tiến hóa harness, README mô tả việc tinh chỉnh một coding harness từ những yêu cầu bằng ngôn ngữ tự nhiên, dùng API mô hình thay cho GPU. Reefine là công thức tinh chỉnh harness có sẵn và đi kèm cấu hình deployment; bạn chỉ định địa chỉ nhà cung cấp và mô hình. Theo mặc định Reef lắng nghe ở cổng 8901 trên máy cục bộ, không xác thực, trừ khi bạn đặt biến REEF_TOKEN trước khi chạy để yêu cầu token. Trạng thái được lưu trong thư mục .reef/reefine.
Ở terminal thứ hai, bạn tạo một kịch bản, cài harness rồi yêu cầu một thay đổi. Trong phiên reef-pi, lệnh /reefine gửi cùng loại yêu cầu. Mô hình được phục vụ sẽ viết thay đổi dưới dạng một skill, một mục quy tắc, một lệnh của agent hoặc một extension của pi. Bạn xem các phiên bản bằng /versions và cài một phiên bản bằng /versions install, nghĩa là có một bước con người duyệt trước khi harness thay đổi được dùng.
Lưu ý về an toàn khi để agent tự sửa harness
README dành khá nhiều chữ cho rủi ro, và đây là phần người đọc nên đọc kỹ. Thư mục cài đặt cần nằm ngoài dự án mà agent làm việc, vì một phiên có thể ghi file trong dự án của nó; nếu thư mục cài nằm trong dự án, agent có thể thay đổi thứ mà phiên kế tiếp sẽ chạy. Điều tương tự đúng với môi trường Python được cài vào reef-pi và bản checkout Reef mà nó import, vì mã ở đó chạy với quyền của bạn khi reef-pi khởi động.
Với codex và dsh, README khuyên tránh cả thư mục tạm của hệ thống, vì sandbox của chúng cho phép lệnh ghi vào đó. Công cụ pi chạy lệnh mà không có sandbox. Còn bộ đề xuất thay đổi chỉ hoạt động như một coding agent chạy thử harness đã sửa trước khi trả kết quả khi máy chủ có thể cô lập nó, cụ thể là Linux với bwrap và pasta, chạy bằng người dùng không phải root. Nếu không, bạn có thể đặt REEF_PROPOSER_SANDBOX bằng none trên một máy mà bạn tin tưởng.
Bài học thực tế: một hệ thống cho agent tự viết lại skill và quy tắc của chính nó là một bề mặt tấn công và một bề mặt lỗi mới. Hãy coi cấu hình sandbox và bước duyệt phiên bản là một phần bắt buộc của thiết kế, không phải tùy chọn.
Công thức và ví dụ có sẵn
README tổ chức các công thức theo loại tác vụ và theo thứ cần tiến hóa, trọng số hay harness. Công thức trọng số cần ngăn xếp huấn luyện GPU; công thức harness chỉ cần một endpoint mô hình. Reefine đi kèm gói reef-infra, còn các cách triển khai khác nằm trong thư mục recipes của repo, được chọn bằng tham chiếu lớp có dấu chấm và không nằm trong gói wheel của Reef.
Với tác vụ khám phá khoa học, các công thức tiến hóa mô hình gồm TTT-Discover và Guidance-TTT, chưa có công thức tiến hóa harness. Các benchmark được đo gồm TriMul, circle packing và Erdős minimum overlap. Với học liên tục trên một dòng tác vụ, công thức mô hình là SAO, công thức harness là Meta-Harness và GEPA, với các benchmark AIME 2025, IMOAnswerBench, CEO-Bench và Terminal-Bench. Với học từ cách dùng thực tế, công thức mô hình là OpenClaw-RL, công thức harness là SkillClaw và Reefine, với benchmark là một học sinh mô phỏng trên dòng tác vụ GSM8K và WildClawBench.
README nói mỗi trang kết quả ghi lại tác vụ, cách thiết lập đánh giá, số đo và các giới hạn. Bài này không trích lại số liệu benchmark vì README chỉ liệt kê tên benchmark và dẫn tới các trang kết quả riêng. Thư mục recipes/basic là ngăn xếp chỉ ghi lại, dùng làm điểm khởi đầu và nằm ngoài danh mục.
Dùng Reef trong workflow xây AI agent
Hình dung một đội đang vận hành một coding agent nội bộ. Họ có thể đặt Reef phía trước mô hình như một proxy tương thích OpenAI, để mọi yêu cầu đi qua nó và được ghi lại. Khi người dùng sửa kết quả của agent hoặc test báo đỗ hay trượt, tín hiệu đó được gửi lại dưới dạng báo cáo phản hồi gắn với biên nhận. Dựa trên đó, công thức tinh chỉnh harness đề xuất thêm một skill hoặc một quy tắc, và người phụ trách duyệt phiên bản trước khi cài. Đây là một kịch bản minh họa suy ra từ các thành phần README mô tả, không phải một quy trình được tác giả công bố.
Tài liệu của dự án được sắp xếp theo thứ tự: Quickstart để cài Reef, kết nối client và xem lịch sử phiên bản; HTTP API để báo phản hồi; hướng dẫn viết công thức; hướng dẫn tiến hóa harness; hướng dẫn tiến hóa mô hình; danh mục công thức; mô tả vòng lõi; và bảng thuật ngữ. Nếu bạn mới làm quen, đi theo đúng thứ tự này sẽ tránh được việc nhảy thẳng vào phần huấn luyện GPU.
Giới hạn và điều README không nói
README không đưa ra số liệu về độ trễ phụ thêm khi đặt Reef trước mô hình, về chi phí vận hành, hay về mức độ ổn định trong sản xuất. Cũng không có nội dung nào về cách xử lý dữ liệu nhạy cảm trong các bản ghi tương tác, dù hệ thống lưu lại tương tác và phản hồi. Nếu agent của bạn xử lý dữ liệu khách hàng, đây là câu hỏi bạn phải tự trả lời trước khi bật ghi nhận.
Dự án còn mới theo thông tin metadata, và README có mục lộ trình riêng nhưng nội dung chi tiết nằm ở trang khác. Việc tự cải thiện cũng phụ thuộc rất nhiều vào chất lượng tín hiệu phản hồi và bộ đánh giá: nếu điểm số sai hoặc thưa, bản cập nhật sinh ra có thể không tốt hơn. README nhấn mạnh phải có tác vụ đại diện và bộ đánh giá cho hướng tối ưu harness, điều này cho thấy tác giả cũng coi đó là điều kiện tiên quyết.
Kết luận: ai nên thử, ai nên chờ
Reef phù hợp với nhóm đã có agent chạy thật, có cách thu phản hồi đáng tin, và muốn biến vòng cải thiện thủ công thành một quy trình có phiên bản. Nếu bạn chỉ có vài tác vụ cố định và không có tín hiệu chấm điểm, chi phí dựng hạ tầng này có thể lớn hơn lợi ích. Nếu bạn muốn huấn luyện trọng số, hãy chuẩn bị GPU và đọc kỹ hướng dẫn tiến hóa mô hình.
Cách thử thận trọng nhất theo README là chạy hướng tiến hóa harness trên một máy cô lập, với thư mục cài đặt nằm ngoài dự án, bật sandbox nếu có thể, và duyệt từng phiên bản bằng tay. Đây là cách rẻ nhất để thấy một vòng Serve, Observe, Grow, Commit chạy thật mà không phải đầu tư hạ tầng huấn luyện.
Bài do AI viết tự động từ README và dữ liệu GitHub API của repo, có kiểm tra tự động nhưng không có người duyệt từng câu. Báo sai sót qua email.